얼마 전 Strata로 Qwen3.8-Flash-Next를 돌려본 이야기를 올렸었다. 평범한(?) 오래된(…) 게임용 PC에서 이 체급의 모델을 초당 수십 토큰으로 돌릴 수 있다는 것만으로도 꽤 신기했는데, 깃헙 새로고침을 하다 보니 이번에는 DeepSeek V4.1-Flash 지원이 들어왔다.
Qwen도 아니고 DeepSeek를? 그 수백 기가짜리 모델을 내 컴퓨터에서? 이건 또 안 눌러볼 수가 없다. 물론, 돌아간다는 것과 쓸 만하다는 것은 전혀 다른 이야기라는 걸 이번에도 다시 확인하게 됐지만… 일단 업데이트부터 해봤다.
이번 업데이트는 DeepSeek, 다만 엔진은 별도입니다
Strata 0.2.4 릴리스에서 DeepSeek V4.1-Flash 지원이 추가됐다. 정확히는 터미널의 strata launch, strata setup을 통해 설치하고 실행하는 방식이다. 이번에 배포된 데스크톱 앱 자체는 0.2.3으로 유지되고, DeepSeek 선택 기능은 아직 들어가지 않았다고 한다. 앱이 지원되면서 확실히 편해지긴 했지만, 거기에서 업데이트랑 모델 목록만 찾고 있으면 조금 헷갈릴 수 있는 부분. 뭐 그래도 금방 업데이트 되긴 할 듯.
기존 Qwen 엔진이 DeepSeek까지 같이 돌려주는 것은 아니고, strata-dsv41이라는 별도 엔진을 나란히 설치한다. Qwen 엔진을 덮어쓰는 구조는 아니다. 모델은 ISTA-DASLab의 양자화 버전을 사용하고, 자주 쓰는 expert는 RAM에 두고 나머지는 SSD에서 읽어오는 방식이라고 한다. 결국 VRAM만으로 안 되면 RAM과 SSD까지 총동원하는 Strata 구조를 확장해서 적용한 셈이다.
공식 안내상으로는 12GB 이상 그래픽카드에 RAM 46~64GB 정도로도 실행이 가능하다. 조건은 2bit 양자화 모델일 때 그렇고 양자화를 조금 올리면 SSD 사용이 더 많아진다. 다만 작아졌다는 모델조차 다운로드 용량이 양자화 종류에 따라 239~274GB다. 메모리에 다 올리지 않아도 된다는 뜻이지, 모델 자체가 갑자기 가벼워진 것은 아니다. SSD 여유 공간부터 확인해야 한다.
30시리즈와 50시리즈 사이에서 사라진 내 4080
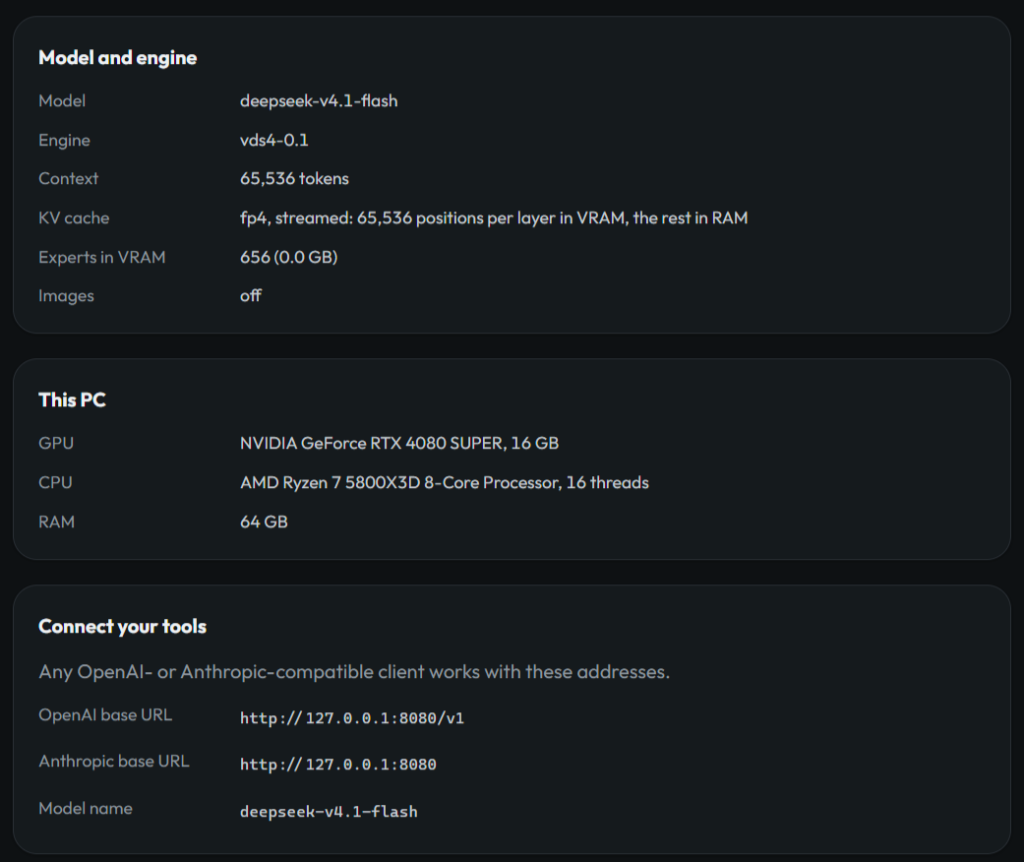
이번에도 예전에 Qwen을 돌렸던 PC를 그대로 사용했다. Ryzen 7 5800X3D, RAM 64GB, RTX 4080 SUPER 16GB 구성이다. 아직 게임용으로도 충분히 현역인 장비인데, 로컬 LLM 앞에서는 늘 뭔가 모자란 기분이다.
업데이트를 적용하고 DeepSeek를 설치하려는데 여기서 한 번 걸렸다. terminal로 설치를 안했다보니 앱하고 별개로 그냥 새로 설치하려했는데, 이 똑똑한 설치스크립트가 기존 설정을 그래도 어느정도 읽어온다. 그런데 자동 설치 과정에서 RTX 30시리즈와 50시리즈만 지원되는 것처럼 나오고, 정작 그 사이에 있는 40시리즈인 내 4080 SUPER는 지원되지 않는다고 나오는 것. (똑똑하다는 말 취소…) 아니, 30도 되고 50도 되는데 40은 어디로 간 건가요… 분명 30 to 50이랬는데, 확인만 3090과 5070에서 했다고 했는데…
다행히 이건 40시리즈에서 아예 실행할 수 없다는 뜻은 아니었다. 공식 릴리스의 NVIDIA용 DSV 엔진 지원 목록에는 RTX 30 / 40 / 50이 모두 들어 있다. 내가 설치하던 시점에는 자동 설치 쪽에서 지원 불가로 표시되는 문제가 있었던 셈이다. 어떤 내부 판정에서 꼬였는지까지 확인한 것은 아니니, 40시리즈 미지원이라고 단정할 일은 아니다.
다행히도 똑똑하진 않지만 친절한 설치스크립트는 따로 엔진을 받아서 설치하면 된다고 안내가 나온다. 영어로 써있어서 처음에 무시했던게 그런 내용이었던 것. 그래서 GitHub 릴리스에서 별도의 strata-dsv41 엔진 패키지를 직접 내려받아 설치하는 것으로 넘어갔다. 공식 문서에도 자동 설치 외에 수동 패키지를 지정하는 --dsv41-package 옵션과 engine-dsv41 폴더를 사용하는 방법이 안내돼 있다. 비슷한 메시지를 만나면 그래픽카드 탓부터 하기 전에 릴리스의 DeepSeek 엔진 패키지와 수동 설치 안내를 확인해보는 편이 좋겠다. 운영체제에 맞는 NVIDIA CUDA 패키지를 고르고, 함께 제공되는 체크섬도 확인하는 것이 기본.
우여곡절 끝에 모델이 올라왔고, 아래처럼 DeepSeek V4.1-Flash와 내 PC 사양이 정상적으로 표시됐다. 컨텍스트는 시험이니 작게 가려다 괜찮으면 바로 webui에라도 물려볼 요량으로 65,536 토큰으로. 일단 실행 성공이다.
돌아갑니다. 그런데 이제 속도가…
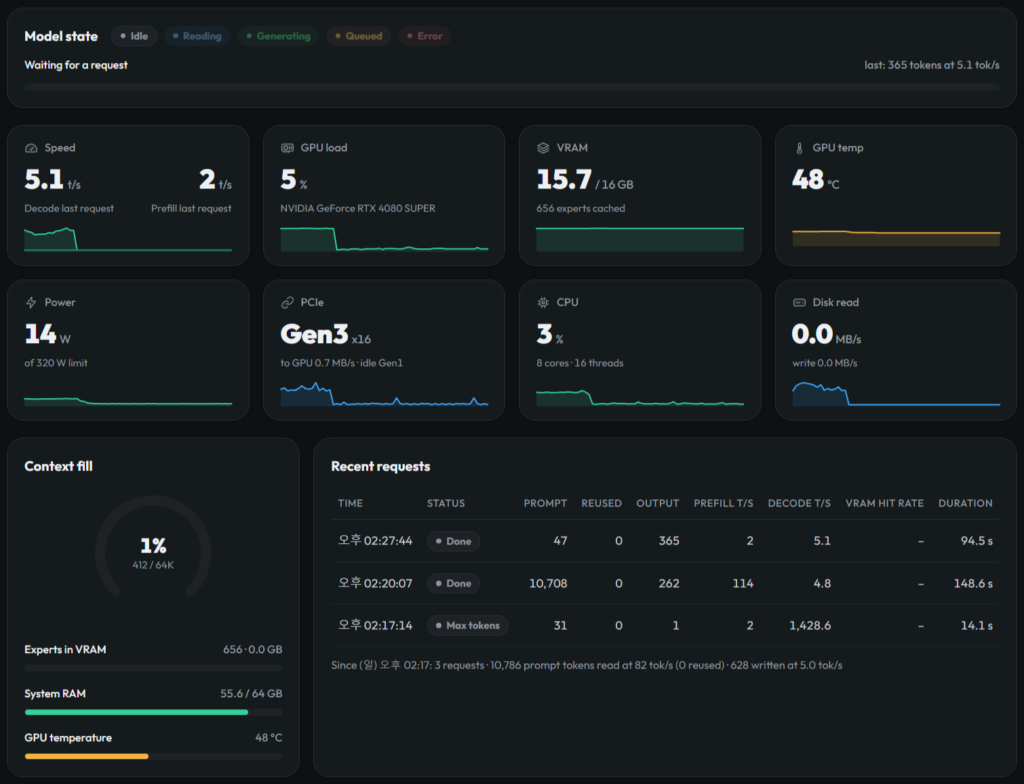
실행해서 요청을 던져본 결과는 아래 화면과 같다. 모델이 응답을 만들고 요청을 끝내는 것까지는 확인했다. 다만 이번 글은 답변 품질을 여러 문제로 검증한 벤치마크라기보다는, 내 PC에서 얼마나 현실적으로 돌릴 수 있는지 확인해본 찍먹 후기에 가깝다.
돌려보며 확인한 속도는 프리필 약 110t/s, 생성 약 5t/s 수준. 프리필은 입력한 프롬프트를 읽는 속도이고, 생성은 실제로 답변 토큰을 뽑아내는 속도다. 두 숫자는 따로 봐야 한다.
물론 요청마다 수치는 달랐다. 첨부 화면의 긴 요청은 입력 10,708토큰에 프리필 114t/s, 생성 4.8t/s로 표시돼 있고, 다른 완료 요청의 생성 속도는 5.1t/s다. 그러니 110t/s가 모든 상황에서 고정으로 나오는 성능이라는 이야기는 아니다. 전체적으로는 입력을 읽는 데도 기다림이 있고, 답변은 초당 다섯 토큰 남짓으로 흘러나오는 정도라고 보면 된다.
5t/s면 단순 계산으로 1,000토큰을 만드는 데만 200초, 3분이 넘게 걸린다. 프롬프트를 읽는 시간은 별도이고, Thinking까지 길어지면 내가 보고 싶은 최종 답변을 만나기까지는 더 기다려야 한다. 가끔 한 번 질문하고 다른 일을 하다 오는 용도라면 몰라도, 답변을 보고 다시 묻고 코드를 고치는 식으로 계속 주고받기에는 꽤 답답한 속도다.
공식 릴리스에도 12GB 카드의 생성 속도는 대략 4~8t/s 수준이고, SSD와 CPU의 영향이 크다고 적혀 있다. 내 결과가 곧 DeepSeek 자체의 한계라거나 RTX 4080 SUPER 전체의 대표 성능이라는 뜻은 아니다. RAM, CPU, 저장장치, 모델과 설정이 같이 얽히는 방식인 만큼, 여기서는 어디까지나 내 환경에서 나온 결과로 봐주시면 된다.
되긴 하는데, 매일 쓰기는 어렵겠다
이 체급의 DeepSeek를 서버도 아닌 집에 있는 PC에서 실행했다는 것 자체는 분명 대단하다. 수백 기가짜리 모델을 VRAM, RAM, SSD에 나눠서 어떻게든 굴러가게 만드는 개발자들의 집념에는 이번에도 감탄하게 된다. 공짜로 풀어주신 것만으로도 감사할 일이고.
하지만 예전 Qwen 때의 “어? 이 정도면 써볼 만한데?”와는 느낌이 다르다. 프리필 110t/s 안팎에 생성 5t/s로는, 적어도 내가 기대하는 실제 활용에는 무리가 있어 보인다. 실행에 성공한 기쁨은 잠깐이고, 그 다음부터는 답변을 기다리는 시간이 더 크게 다가온다. 돌아간다와 쓸 만하다 사이의 거리는 역시 멀다.
그래서 지금은 DeepSeek를 이 환경에서 본격적으로 쓰기보다는, 앞으로 나올 Qwen4가 더 기대된다. 어떤 사양과 속도로 나올지는 나와봐야 알겠지만, 내게 필요한 것은 거대한 모델을 간신히 띄웠다는 인증보다는 적당한 하드웨어에서 매일 부담 없이 쓸 수 있는 모델이니까. 그때도 또 깃헙 새로고침을 하고 있겠지…
참고: Strata GitHub · 0.2.4 릴리스 및 DeepSeek 수동 설치 안내. 작성 시점에는 같은 릴리스 페이지에 터미널 0.2.4.2의 설치·실행 관련 수정도 추가돼 있다. 위 결과는 내가 실행해 첨부한 화면 기준이며, 이후 버전에서 같은 성능이나 설치 문제가 그대로 재현된다는 뜻은 아니다.
지난 Strata 글에서 맥미니 살 때 메모리를 좀 넉넉하게 샀어야 했다고 한탄을 했었다. M4 Pro 24GB로 로컬 LLM을 만지다 보면 꼭 그 생각이 든다. 모델은 좋은데 안 들어가고, 들어가는 걸 고르면 뭔가 아쉽고. 그래서 메모리만 늘리면 이 고민이 끝날 줄 알았는데…
이번에는 맥미니 M5 Pro 64GB를 기준으로 뭘 올리는게 가장 나을지 정리해봤다. 결론부터 말하면, 메모리가 늘어나니 이제는 양자화랑 실행 엔진을 고르는 고민이 시작된다. 이 취미는 정말 친절하다. 다음 고민거리를 끊임없이 공급해준다.
먼저 선을 하나 긋고 시작하자. 이 글은 2026년 10월 23일까지 공개된 공식 문서와 벤치마크, 사용자 보고를 모아본 정리다. 아래 속도는 내 맥미니에서 직접 재서 만든 사용기가 아니다. 특히 개발자가 올린 최고 기록이랑 실제 사용자 보고를 섞어서 “내 컴퓨터에서도 이 속도 나온다”고 읽으면 곤란하다. 그 부분은 가능한 한 나눠 적었다.
한 줄 요약부터
모델 하나만 고르면 Qwen3.8-27B. 품질과 속도의 균형은 6비트, 빠른 코딩은 4비트에 DFlash2, 처리 속도를 더 챙기고 싶으면 Qwen3.6-35B-A3B. 그리고 이미 mlx-serve를 쓰고 있다면 일단 그걸 제대로 세팅하는게 먼저다. 새 엔진 나왔다고 매번 이사부터 갈 필요는 없다. 물론 구경은 해야겠지만…
1. 64GB면 큰 모델부터 올려야 하는거 아닌가
일단 메모리가 64GB라고 해서 모델에 64GB를 몽땅 줄 수 있는 건 아니다. macOS도 먹고 살아야 하고, 모델 웨이트 외에 KV cache, 추론용 작업 공간, speculative decoding에 쓰는 작은 draft 모델도 자리를 차지한다. 다운로드 파일이 40GB라고 실행 메모리도 딱 40GB일 거라고 생각하면, 그때부터 스왑과 친해지게 된다.
M5 Pro의 공식 메모리 대역폭은 307GB/s다. 용량은 “무엇을 올릴 수 있나”를 정하고, 대역폭은 특히 단일 요청의 토큰 생성 속도에 큰 영향을 준다. M5 GPU의 Neural Accelerator가 긴 프롬프트를 읽는 연산을 도와주는 것과, 매 토큰마다 웨이트를 읽어오는 속도는 또 다른 이야기다. TOPS 숫자만 보고 있으면 이 동네에서 자꾸 길을 잃는다.
실제로 같은 Mac mini M5 Pro 64GB에서 Qwen3.8-27B를 llama.cpp로 돌린 공개 측정이 있다. Q8_0은 추측 디코딩 없이 약 10 tok/s, 훨씬 작은 IQ3_S는 약 20 tok/s였다. 전자는 27.1GiB, 후자는 11.3GiB짜리 파일이다. 다만 이 수치를 다른 엔진까지 그대로 적용하면 안 된다. 곧 나오겠지만, 작은 draft가 토큰을 미리 제안하고 본 모델이 묶어서 검증하는 식으로 계산 구조를 바꾸면 상황이 꽤 달라진다.
그러니까 목표를 “64GB를 끝까지 채우기”로 잡을 필요는 없다. 적당한 모델을 빠르게 돌리고, 긴 대화가 쌓여도 버티고, 다른 앱 켰다고 갑자기 굼떠지지 않는 쪽이 실제로는 훨씬 자주 쓰게 될 구성이다. 벤치마크 한 번 찍고 종료할게 아니라면.
2. 주력은 여전히 Qwen3.8-27B
공식 모델 카드와 현재 엔진 지원을 같이 놓고 보면 가장 무난한 출발점은 Qwen3.8-27B다. 코드, 문서, 일반 질문, 도구 호출을 두루 맡길 수 있고 이미지도 받는다. 기본 컨텍스트는 262,144토큰. 물론 모델이 지원하는 최대 길이와 64GB 맥에서 쾌적하게 쓸 길이는 다른 이야기다.
양자화는 세 갈래로 보면 편하다. 4비트는 속도, 6비트는 균형, 8비트는 원본에 대한 충실도. 64GB가 있으니 무조건 8비트라는 결론은 아니다. 양자화 오차가 줄어드는 것과 내가 맡긴 작업의 정답률이 눈에 띄게 올라가는 건 같은 말이 아니고, 늘어난 웨이트를 읽는 비용은 매번 내야 한다.
내가 고를 기준은 6비트를 품질 비교용으로 먼저 두고, 4비트에 DFlash2를 붙인 결과가 실제 작업에서 충분히 괜찮은지 보는 쪽이다. 답이 사실상 같다면 빠른 쪽을 쓰면 된다. 반대로 반복 호출이나 지시 누락이 줄어든다면 조금 느려도 덜 깎은 쪽을 남길 이유가 생긴다. 파일 크기는 변환한 저장소마다 다르니 “27B 6비트는 몇 GB” 하고 한 숫자로 외우지는 말자.
특히 ddalcu의 6비트 모델 카드는 용량 설명 일부가 서로 맞지 않는 부분이 있어서 이 글에서는 확정 용량표에 넣지 않았다. 다운로드할 저장소의 실제 파일 합계를 확인하는 편이 낫다. 인터넷을 뒤지다 보면 숫자보다 숫자 옆의 작은 글씨가 더 중요한 경우가 많다.
3. 빠른 일꾼은 Qwen3.6-35B-A3B
이름만 보면 35B니까 27B보다 더 무거울 것 같지만, 이건 MoE다. 전체는 35B이고 토큰마다 약 3B를 활성화한다. 모델을 메모리에 올리는 용량은 전체 기준으로 필요하지만, 매번 계산하는 양은 그보다 훨씬 작다. 그래서 반복적인 코드 수정, 요약, 분류, 정보 추출 같은 일을 많이 시키려면 꽤 매력적인 선택지가 된다.
아래 엔진 비교에서도 이 모델은 확실히 빠르다. 다만 속도가 빠르다고 어려운 문제까지 더 잘 푼다는 뜻은 아니다. 주력 답변의 품질은 27B로 확인하고, 자주 반복하는 일을 35B-A3B에 맡기는 식으로 역할을 나눠볼 만하다. 메모리가 넉넉하다고 둘을 꼭 동시에 띄워놔야 하는 것도 아니다. 필요할 때 갈아 끼우면 된다.
4. 한국어 글쓰기와 큰 모델 욕심은 별도 트랙으로
한국어 문서나 글쓰기는 Gemma 4 31B도 비교 후보로 두고 싶다. 31B dense 모델이고 이미지 입력, 추론 모드, 함수 호출을 지원한다. 참고로 Gemma 4는 Apache 2.0이다. 예전 Gemma 라이선스만 기억하고 있으면 헷갈릴 수 있는 부분.
그렇다고 “한국어는 Gemma가 무조건 최고”라고 적을 근거는 못 찾았다. 같은 한국어 문제를 같은 조건으로 제대로 비교한 자료가 부족하다. 요약에서 뭘 빼먹는지, 번역투가 얼마나 남는지, 내가 원하는 문체가 나오는지는 직접 같은 글을 던져보고 고르는게 맞다. 영어 벤치마크 숫자가 내 블로그 말투까지 대신 골라주지는 않는다.
그리고 큰 모델을 올려보고 싶은 마음을 자극하는 쪽에는 Qwen3.8-Flash-Next가 있다. 공식 설명은 본체 125B에 n-gram embedding 51B, MTP 4B를 더한 구조다. 어디서는 125B라고 하고 어디서는 180B라고 하는 이유가 여기에 있다. 이걸 64GB에서? 싶지만 저비트 양자화와 SSD 스트리밍을 같이 쓰면 가능해졌다.
GSQ-RCO Q2_0 기준으로 본체 shard는 37.6GB, n-gram shard는 28.8GB다. 합치면 66.4GB인데 n-gram 테이블을 SSD에 두고 필요한 부분만 읽는 식이다. 여기에 draft, KV cache, 작업 공간은 별도로 생각해야 한다. 이건 모든 데이터가 RAM에 올라간 4비트 27B와는 운영 조건부터 다르다.
Splash 1.4.0 개발자 측정에서는 M5 Pro 20코어 GPU, 64GB에서 Flash-Next Q2_0으로 95 tok/s가 나왔다. 솔깃하다. 다만 선택된 코드 프롬프트에 DFlash2를 사용한 결과이고, Q2 양자화의 품질도 따로 봐야 한다. 양자화 제작자 평가에서 LiveCodeBench는 BF16의 87.43에서 Q2의 81.14로 내려갔다. 이것만으로 한국어나 긴 에이전트 작업의 품질까지 설명할 수는 없다.
게다가 10월 21~22일에는 같은 M5 Pro 64GB에서 Splash 1.4.0의 도구 호출이 반복된다는 사용자 보고도 올라왔다. 원인이나 모든 환경의 문제로 확정할 수는 없지만, 지금 당장 주력으로 밀어붙이기보다는 실험용으로 남겨두고 싶다. Flash-Next는 Qwen Community License 1.0이라 상업 서비스에 쓸 때는 조건도 별도로 확인해야 한다. 큰 모델이라고 고민까지 작아지는 건 아니다.
5. 진짜 변수는 실행 엔진이었다
이번에 정리하면서 가장 크게 생각이 바뀐 부분이다. 한때는 “맥이면 MLX”, 조금 지나서는 “Qwen이면 Splash” 같은 한 줄 결론으로 정리하고 싶었는데, 최신 자료까지 보면 그렇게 단순하지 않았다. 이미 쓰는 mlx-serve도 DFlash2를 제대로 붙이면 꽤 빠르고, Kapitsa라는 새 엔진도 공격적으로 속도를 끌어올리고 있다.
아래는 Kapitsa 프로젝트가 공개한 비교 자료에서 가져온 생성 속도다. MacBook Pro M5 Pro, 20코어 GPU, 48GB에서 코드 응답을 temperature 0.6으로 생성한 값이다. 내 맥미니 64GB 실측이 아니고, 일부 셀은 측정 날짜와 빌드가 다르며 다른 앱의 GPU 사용이 감지된 실행도 포함된다. 엔진 개발자 측 자료라는 점까지 감안하고 봐야 한다.
4비트 모델
mlx-serve 26.10.2
Splash 1.4.0
Kapitsa 개발 빌드
Qwen3.8-27B
약 78 tok/s
약 72 tok/s
약 81 tok/s
Qwen3.6-35B-A3B
약 156 tok/s
약 181 tok/s
약 201 tok/s
27B에서 mlx-serve는 DFlash2, Splash도 DFlash2, Kapitsa는 KFlash를 사용한 결과다. 35B-A3B에서 mlx-serve는 MTP다. 동일 모델이라고 모든 세팅까지 동일한 비교는 아니라는 얘기. 특히 27B의 mlx-serve와 Kapitsa 차이는 자료 작성자도 측정 편차 안의 사실상 동률로 본다. 저 숫자만 보고 3 tok/s 더 빠르다고 이사 갈 일은 아니다.
반대로 같은 비교 세션에서 Splash는 두 모델 모두 프롬프트를 읽는 속도가 더 빨랐다. 새로 긴 문서를 자주 넣는 작업이라면 토큰 생성 순위와 전체 작업 시간 순위가 달라질 수 있다. 생성 속도는 GPU가 말을 하기 시작한 뒤의 속도고, 그 전에 문서를 읽고 생각하느라 기다리는 시간은 따로다.
실제 맥미니 M5 Pro 64GB 사용자 보고도 같이 보자. Splash에서 Qwen3.8-27B UD-Q4_K_XL로 약 50 tok/s, Q8_0으로 4K 입력에서 약 35.3 tok/s를 기록한 사례가 있다. 서로 프롬프트와 양자화가 다르니 위 표와 한 줄로 순위를 매길 수는 없다. 다만 “최대 74”나 “최대 81”이 내가 아무 질문이나 던졌을 때의 보장 속도가 아니라는 건 분명하다.
그래서 지금 판단은 이렇다. 이미 mlx-serve를 쓰면 업데이트와 DFlash2 설정부터. 긴 새 입력이 많으면 Splash 비교. 생성 속도 한계까지 보고 싶으면 Kapitsa를 추가로 시험. LM Studio나 oMLX가 편하면 그것도 괜찮지만 앱 이름만 보지 말고 실제 backend가 뭔지 확인할 것. 같은 간판 아래에서도 엔진이 다르면 결과가 달라진다.
6. 성능 튜닝은 이 순서로
첫째, speculative decoding이 실제로 켜져 있는지 확인. 작은 모델이 다음 토큰들을 미리 제안하고 본 모델이 검증하는 방식이다. MTP와 DFlash2는 구현이 다르고 잘 맞는 작업도 다르다. 코드의 들여쓰기나 반복되는 식별자처럼 예측하기 쉬운 출력에서는 이득이 크지만, 새로운 설명문을 쓰는 상황에서는 줄어들 수 있다. draft 길이는 길수록 좋은게 아니다.
둘째, 컨텍스트는 32K부터. 일반 대화와 짧은 코드는 32K, 문서나 저장소 분석은 64K로 시작하고 정말 필요할 때 더 늘리는 편이 낫겠다. 에이전트의 시스템 프롬프트와 도구 정의만으로 수만 토큰을 쓰는 경우도 있으니 무조건 32K면 된다는 뜻은 아니다. 모델이 256K를 지원한다고 설정부터 끝까지 올릴 이유는 없다는 이야기다.
셋째, prefix cache는 살려둘 것. 공개된 Mac mini M5 Pro llama.cpp 측정에서 32K 문맥에 512개 새 토큰을 더한 입력은 캐시 없이 첫 토큰까지 약 110초, 문맥 캐시가 맞으면 약 2.4초였다. 에이전트는 같은 시스템 프롬프트와 대화를 계속 다시 보내니 이런 차이가 크게 쌓인다. 캐시가 맞은 숫자를 “프롬프트 읽기 성능”이라고 자랑하는 것도 조심해야 한다. 안 읽었으니 빠른 것일 수 있다.
넷째, KV cache 양자화는 엔진별로 접근. 웨이트를 4비트로 줄이는 것과 KV cache를 4비트로 줄이는 건 다른 설정이다. mlx-serve는 메모리가 충분하면 KV 양자화 off부터 비교하고, 메모리가 부족해질 때 8비트를 검토하는 쪽이 출발점이다. 반면 Splash는 기본이 INT8 KV다. 한 엔진의 최적 세팅을 다른 엔진에 그대로 복사하는 건 별로 좋은 방법이 아니다.
다섯째, 혼자 쓰면 동시 요청은 1개부터. 여러 요청을 묶으면 전체 처리량은 늘어도 내 질문 하나가 끝나는 시간은 길어질 수 있다. 여러 에이전트를 굴릴 때만 2개, 4개로 늘려보고, 일반 채팅에서는 일단 단순하게 시작하자.
여섯째, thinking 양과 메모리 압박 확인. 단순 요약은 thinking을 끄거나 낮춰보고, 어려운 코드 수정은 충분히 생각하게 하는 쪽이 낫다. 낮추면 매 턴은 짧아져도 틀려서 재시도하면 전체는 더 오래 걸린다. 활동 모니터에서 메모리 압박과 작업 중 스왑 증가도 보자. 큰 모델을 서버마다 중복으로 올려놓고 “왜 느리지?” 하고 있으면 모델은 좀 억울할 수 있다.
저전력 모드는 끄고, 고성능 모드가 제공되는 환경이면 자동 모드와 비교할 만하다. 다만 특정 구형 엔진에서 크게 빨라졌다는 한 번의 측정을 모든 모델에 일반화하지는 말자. GPU 메모리 한도부터 무작정 올리는 sysctl 튜닝도 뒤로 미루겠다. 일단 정상적으로 메모리에 들어가는 모델부터 잘 굴리는게 순서다.
7. 일단 이렇게 시작해볼 생각
mlx-serve에서는 우선 아래처럼 4비트 모델에 기본 MTP를 쓰는 구성을 기준점으로 삼을 수 있다. 앱에서 이미 서버가 떠 있다면 CLI까지 중복으로 띄우지 말고 하나만 사용하자. 아래는 추천 시작 설정이지, 내 맥에서 완료 검증한 설치 절차는 아니다.
위 명령은 기본 MTP다. 앞의 비교표에서 나온 DFlash2 속도를 내려면 호환되는 Qwen3.8-27B-DFlash2 draft를 따로 로컬에 받고, 실제 디렉터리를 –drafter로 지정해야 한다. 공개 벤치마크 구성은 그때 –no-mtp도 함께 사용했다. 시작 로그에서 DFlash나 drafter ready 같은 표시를 확인할 것. 모델에 MTP가 들어 있다고 자동으로 DFlash2가 되는 건 아니다.
Splash는 대응되는 draft를 자동으로 받는 쪽이라 비교 시작은 더 간단하다. M3 이상, macOS 26.4 이상이 필요하다. 처음 설치하는 경우는 다음과 같다. 이미 설치했다면 install 대신 업그레이드하고 기존 서버를 먼저 종료하면 된다.
이미지나 PDF 입력이 전혀 필요 없을 때만 –language-only를 추가하면 된다. –idle-release off는 유휴 상태에도 모델을 남겨두는 옵션이고, –persistent-cache는 재시작 뒤에도 SSD의 대화 캐시를 재사용하기 위한 옵션이다. 여기의 16G는 모델 저장 공간을 지정한게 아니라 캐시 한도다.
M4 Pro 24GB까지 같이 쓴다면 메모리를 억지로 합칠 생각부터 하기보다는 작은 모델, 임베딩, 리랭킹, 음성 인식 같은 일을 나누는 쪽부터 보겠다. mlx-serve의 LAN Sharing은 다른 맥의 모델로 요청을 전달하는 기능이다. 64+24를 체크박스 하나로 88GB짜리 맥으로 만들어주는 기능은 아니다. 별도의 분산 추론 기능과는 구분해야 한다.
그래서 결론은
64GB가 생기면 가장 큰 모델부터 받아보고 싶은게 사람 마음이다. 하지만 이번에 자료를 모아보니 실용적인 출발점은 생각보다 소박했다. Qwen3.8-27B를 주력으로 놓고, 양자화와 draft, cache가 제대로 맞물리게 만드는 것. 속도가 더 필요한 일은 Qwen3.6-35B-A3B로 보내고, Flash-Next는 일단 별도의 실험 과제로 남겨두는 쪽이다.
최종 선택은 같은 한국어 요약, 코드 수정, 긴 문서 질문을 열 개쯤 준비해서 돌려보면 될 것 같다. 첫 응답까지 걸린 시간, 최종 답까지 걸린 시간, 정답률, 도구를 쓸데없이 반복하는지. 이 네 가지를 보면 tok/s 하나만 볼 때보다 훨씬 빨리 답이 나올 것이다.
메모리 고민을 끝내려고 메모리를 늘렸더니 이번엔 엔진이랑 draft를 고르고 있다. 결국 로컬 LLM은 “내 컴퓨터에서 AI를 쓴다”는 취미인 동시에 “AI를 쓰기 좋은 컴퓨터 상태를 계속 만든다”는 취미인 모양이다. 뭐… 그 과정이 재밌으니까 계속 이러고 있겠지만.
참고한 자료
날짜가 있는 수치는 위에 적은 기준일의 공개 자료다. 엔진 업데이트가 워낙 빠르니 설치할 때는 버전과 알려진 문제를 다시 확인하는게 좋겠다. 서로 다른 벤치마크의 품질 점수는 평가 도구와 문제 구성이 다를 수 있어 한 표로 순위를 매기지 않았다.