얼마 전 Strata로 Qwen3.8-Flash-Next를 돌려본 이야기를 올렸었다. 평범한(?) 오래된(…) 게임용 PC에서 이 체급의 모델을 초당 수십 토큰으로 돌릴 수 있다는 것만으로도 꽤 신기했는데, 깃헙 새로고침을 하다 보니 이번에는 DeepSeek V4.1-Flash 지원이 들어왔다.
Qwen도 아니고 DeepSeek를? 그 수백 기가짜리 모델을 내 컴퓨터에서? 이건 또 안 눌러볼 수가 없다. 물론, 돌아간다는 것과 쓸 만하다는 것은 전혀 다른 이야기라는 걸 이번에도 다시 확인하게 됐지만… 일단 업데이트부터 해봤다.
이번 업데이트는 DeepSeek, 다만 엔진은 별도입니다
Strata 0.2.4 릴리스에서 DeepSeek V4.1-Flash 지원이 추가됐다. 정확히는 터미널의 strata launch, strata setup을 통해 설치하고 실행하는 방식이다. 이번에 배포된 데스크톱 앱 자체는 0.2.3으로 유지되고, DeepSeek 선택 기능은 아직 들어가지 않았다고 한다. 앱이 지원되면서 확실히 편해지긴 했지만, 거기에서 업데이트랑 모델 목록만 찾고 있으면 조금 헷갈릴 수 있는 부분. 뭐 그래도 금방 업데이트 되긴 할 듯.
기존 Qwen 엔진이 DeepSeek까지 같이 돌려주는 것은 아니고, strata-dsv41이라는 별도 엔진을 나란히 설치한다. Qwen 엔진을 덮어쓰는 구조는 아니다. 모델은 ISTA-DASLab의 양자화 버전을 사용하고, 자주 쓰는 expert는 RAM에 두고 나머지는 SSD에서 읽어오는 방식이라고 한다. 결국 VRAM만으로 안 되면 RAM과 SSD까지 총동원하는 Strata 구조를 확장해서 적용한 셈이다.
공식 안내상으로는 12GB 이상 그래픽카드에 RAM 46~64GB 정도로도 실행이 가능하다. 조건은 2bit 양자화 모델일 때 그렇고 양자화를 조금 올리면 SSD 사용이 더 많아진다. 다만 작아졌다는 모델조차 다운로드 용량이 양자화 종류에 따라 239~274GB다. 메모리에 다 올리지 않아도 된다는 뜻이지, 모델 자체가 갑자기 가벼워진 것은 아니다. SSD 여유 공간부터 확인해야 한다.
30시리즈와 50시리즈 사이에서 사라진 내 4080
이번에도 예전에 Qwen을 돌렸던 PC를 그대로 사용했다. Ryzen 7 5800X3D, RAM 64GB, RTX 4080 SUPER 16GB 구성이다. 아직 게임용으로도 충분히 현역인 장비인데, 로컬 LLM 앞에서는 늘 뭔가 모자란 기분이다.
업데이트를 적용하고 DeepSeek를 설치하려는데 여기서 한 번 걸렸다. terminal로 설치를 안했다보니 앱하고 별개로 그냥 새로 설치하려했는데, 이 똑똑한 설치스크립트가 기존 설정을 그래도 어느정도 읽어온다. 그런데 자동 설치 과정에서 RTX 30시리즈와 50시리즈만 지원되는 것처럼 나오고, 정작 그 사이에 있는 40시리즈인 내 4080 SUPER는 지원되지 않는다고 나오는 것. (똑똑하다는 말 취소…) 아니, 30도 되고 50도 되는데 40은 어디로 간 건가요… 분명 30 to 50이랬는데, 확인만 3090과 5070에서 했다고 했는데…
다행히 이건 40시리즈에서 아예 실행할 수 없다는 뜻은 아니었다. 공식 릴리스의 NVIDIA용 DSV 엔진 지원 목록에는 RTX 30 / 40 / 50이 모두 들어 있다. 내가 설치하던 시점에는 자동 설치 쪽에서 지원 불가로 표시되는 문제가 있었던 셈이다. 어떤 내부 판정에서 꼬였는지까지 확인한 것은 아니니, 40시리즈 미지원이라고 단정할 일은 아니다.
다행히도 똑똑하진 않지만 친절한 설치스크립트는 따로 엔진을 받아서 설치하면 된다고 안내가 나온다. 영어로 써있어서 처음에 무시했던게 그런 내용이었던 것. 그래서 GitHub 릴리스에서 별도의 strata-dsv41 엔진 패키지를 직접 내려받아 설치하는 것으로 넘어갔다. 공식 문서에도 자동 설치 외에 수동 패키지를 지정하는 --dsv41-package 옵션과 engine-dsv41 폴더를 사용하는 방법이 안내돼 있다. 비슷한 메시지를 만나면 그래픽카드 탓부터 하기 전에 릴리스의 DeepSeek 엔진 패키지와 수동 설치 안내를 확인해보는 편이 좋겠다. 운영체제에 맞는 NVIDIA CUDA 패키지를 고르고, 함께 제공되는 체크섬도 확인하는 것이 기본.
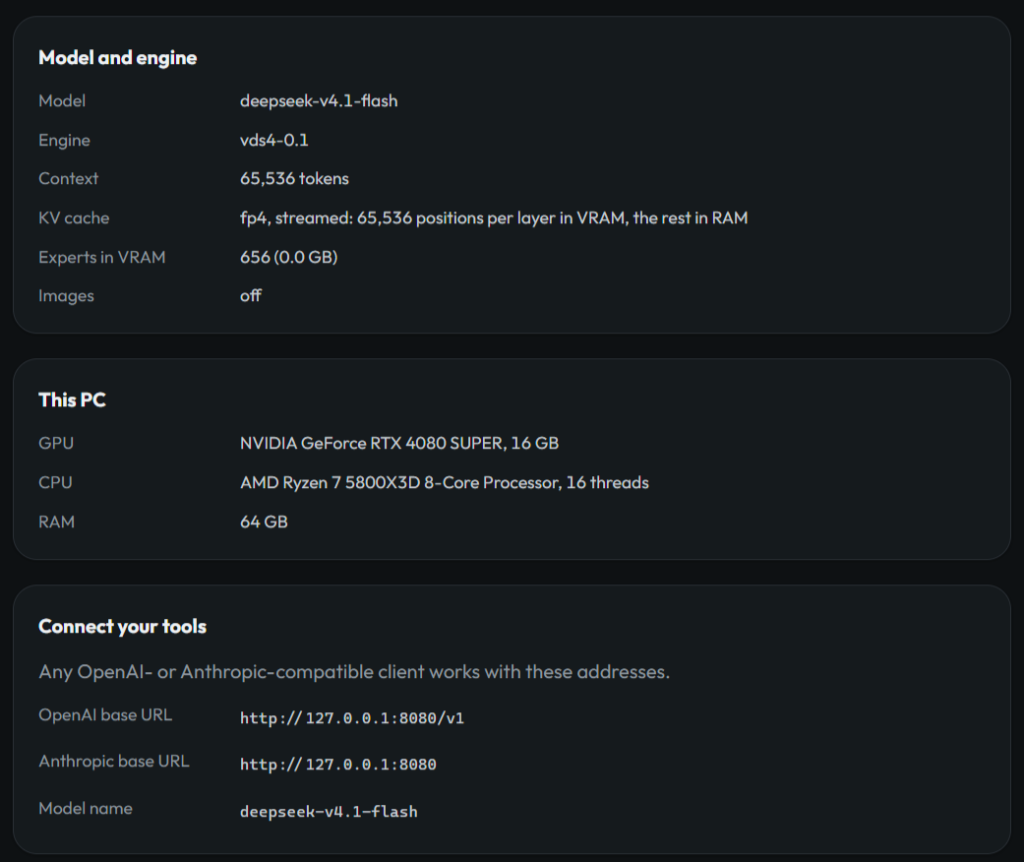
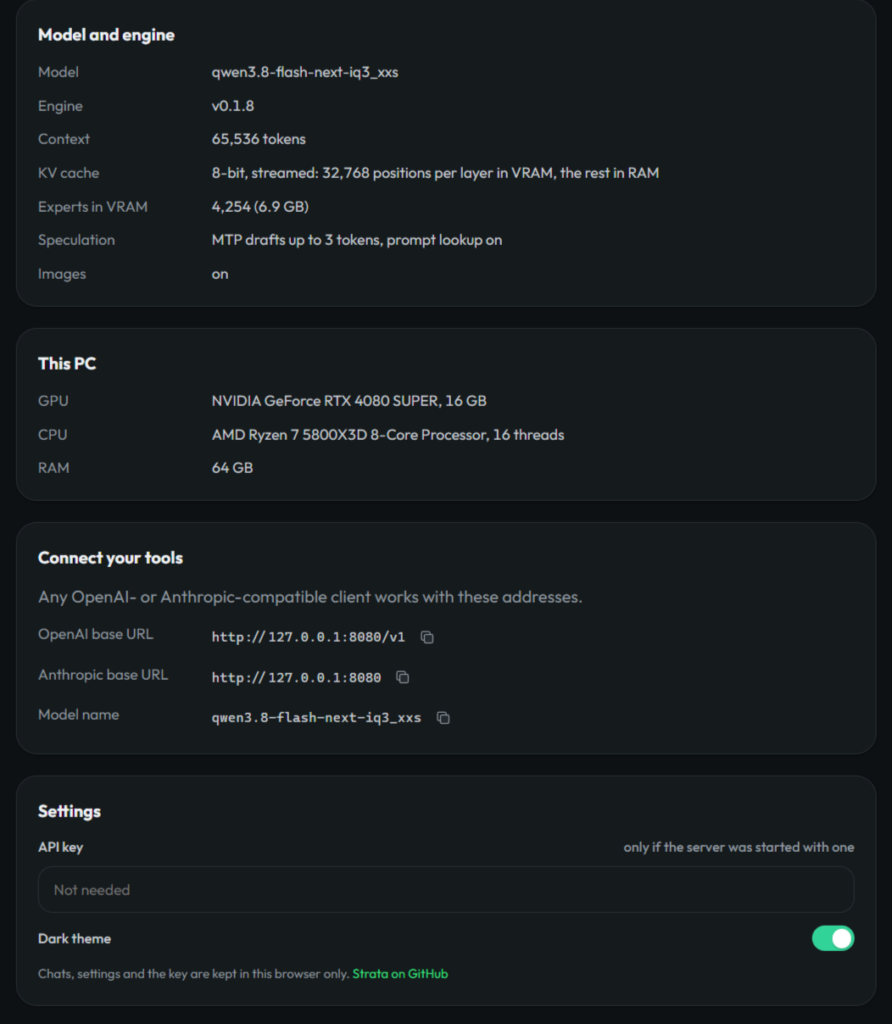
우여곡절 끝에 모델이 올라왔고, 아래처럼 DeepSeek V4.1-Flash와 내 PC 사양이 정상적으로 표시됐다. 컨텍스트는 시험이니 작게 가려다 괜찮으면 바로 webui에라도 물려볼 요량으로 65,536 토큰으로. 일단 실행 성공이다.
돌아갑니다. 그런데 이제 속도가…
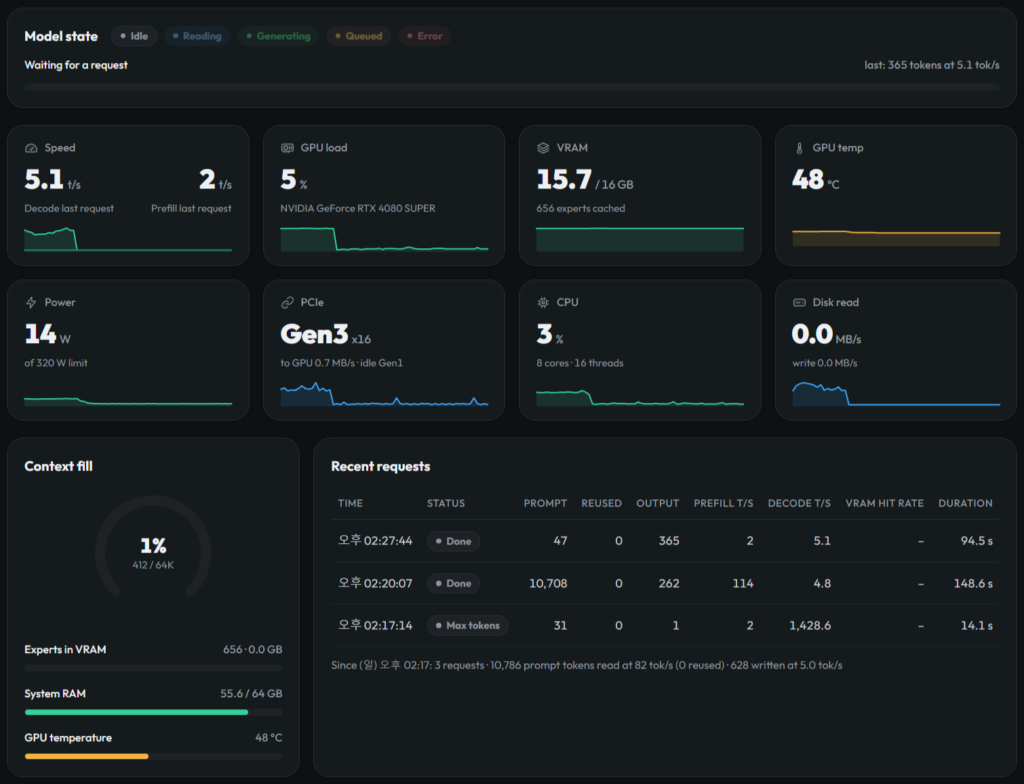
실행해서 요청을 던져본 결과는 아래 화면과 같다. 모델이 응답을 만들고 요청을 끝내는 것까지는 확인했다. 다만 이번 글은 답변 품질을 여러 문제로 검증한 벤치마크라기보다는, 내 PC에서 얼마나 현실적으로 돌릴 수 있는지 확인해본 찍먹 후기에 가깝다.
돌려보며 확인한 속도는 프리필 약 110t/s, 생성 약 5t/s 수준. 프리필은 입력한 프롬프트를 읽는 속도이고, 생성은 실제로 답변 토큰을 뽑아내는 속도다. 두 숫자는 따로 봐야 한다.
물론 요청마다 수치는 달랐다. 첨부 화면의 긴 요청은 입력 10,708토큰에 프리필 114t/s, 생성 4.8t/s로 표시돼 있고, 다른 완료 요청의 생성 속도는 5.1t/s다. 그러니 110t/s가 모든 상황에서 고정으로 나오는 성능이라는 이야기는 아니다. 전체적으로는 입력을 읽는 데도 기다림이 있고, 답변은 초당 다섯 토큰 남짓으로 흘러나오는 정도라고 보면 된다.
5t/s면 단순 계산으로 1,000토큰을 만드는 데만 200초, 3분이 넘게 걸린다. 프롬프트를 읽는 시간은 별도이고, Thinking까지 길어지면 내가 보고 싶은 최종 답변을 만나기까지는 더 기다려야 한다. 가끔 한 번 질문하고 다른 일을 하다 오는 용도라면 몰라도, 답변을 보고 다시 묻고 코드를 고치는 식으로 계속 주고받기에는 꽤 답답한 속도다.
공식 릴리스에도 12GB 카드의 생성 속도는 대략 4~8t/s 수준이고, SSD와 CPU의 영향이 크다고 적혀 있다. 내 결과가 곧 DeepSeek 자체의 한계라거나 RTX 4080 SUPER 전체의 대표 성능이라는 뜻은 아니다. RAM, CPU, 저장장치, 모델과 설정이 같이 얽히는 방식인 만큼, 여기서는 어디까지나 내 환경에서 나온 결과로 봐주시면 된다.
되긴 하는데, 매일 쓰기는 어렵겠다
이 체급의 DeepSeek를 서버도 아닌 집에 있는 PC에서 실행했다는 것 자체는 분명 대단하다. 수백 기가짜리 모델을 VRAM, RAM, SSD에 나눠서 어떻게든 굴러가게 만드는 개발자들의 집념에는 이번에도 감탄하게 된다. 공짜로 풀어주신 것만으로도 감사할 일이고.
하지만 예전 Qwen 때의 “어? 이 정도면 써볼 만한데?”와는 느낌이 다르다. 프리필 110t/s 안팎에 생성 5t/s로는, 적어도 내가 기대하는 실제 활용에는 무리가 있어 보인다. 실행에 성공한 기쁨은 잠깐이고, 그 다음부터는 답변을 기다리는 시간이 더 크게 다가온다. 돌아간다와 쓸 만하다 사이의 거리는 역시 멀다.
그래서 지금은 DeepSeek를 이 환경에서 본격적으로 쓰기보다는, 앞으로 나올 Qwen4가 더 기대된다. 어떤 사양과 속도로 나올지는 나와봐야 알겠지만, 내게 필요한 것은 거대한 모델을 간신히 띄웠다는 인증보다는 적당한 하드웨어에서 매일 부담 없이 쓸 수 있는 모델이니까. 그때도 또 깃헙 새로고침을 하고 있겠지…
참고: Strata GitHub · 0.2.4 릴리스 및 DeepSeek 수동 설치 안내. 작성 시점에는 같은 릴리스 페이지에 터미널 0.2.4.2의 설치·실행 관련 수정도 추가돼 있다. 위 결과는 내가 실행해 첨부한 화면 기준이며, 이후 버전에서 같은 성능이나 설치 문제가 그대로 재현된다는 뜻은 아니다.
지난 Strata 글에서 맥미니 살 때 메모리를 좀 넉넉하게 샀어야 했다고 한탄을 했었다. M4 Pro 24GB로 로컬 LLM을 만지다 보면 꼭 그 생각이 든다. 모델은 좋은데 안 들어가고, 들어가는 걸 고르면 뭔가 아쉽고. 그래서 메모리만 늘리면 이 고민이 끝날 줄 알았는데…
이번에는 맥미니 M5 Pro 64GB를 기준으로 뭘 올리는게 가장 나을지 정리해봤다. 결론부터 말하면, 메모리가 늘어나니 이제는 양자화랑 실행 엔진을 고르는 고민이 시작된다. 이 취미는 정말 친절하다. 다음 고민거리를 끊임없이 공급해준다.
먼저 선을 하나 긋고 시작하자. 이 글은 2026년 10월 23일까지 공개된 공식 문서와 벤치마크, 사용자 보고를 모아본 정리다. 아래 속도는 내 맥미니에서 직접 재서 만든 사용기가 아니다. 특히 개발자가 올린 최고 기록이랑 실제 사용자 보고를 섞어서 “내 컴퓨터에서도 이 속도 나온다”고 읽으면 곤란하다. 그 부분은 가능한 한 나눠 적었다.
한 줄 요약부터
모델 하나만 고르면 Qwen3.8-27B. 품질과 속도의 균형은 6비트, 빠른 코딩은 4비트에 DFlash2, 처리 속도를 더 챙기고 싶으면 Qwen3.6-35B-A3B. 그리고 이미 mlx-serve를 쓰고 있다면 일단 그걸 제대로 세팅하는게 먼저다. 새 엔진 나왔다고 매번 이사부터 갈 필요는 없다. 물론 구경은 해야겠지만…
1. 64GB면 큰 모델부터 올려야 하는거 아닌가
일단 메모리가 64GB라고 해서 모델에 64GB를 몽땅 줄 수 있는 건 아니다. macOS도 먹고 살아야 하고, 모델 웨이트 외에 KV cache, 추론용 작업 공간, speculative decoding에 쓰는 작은 draft 모델도 자리를 차지한다. 다운로드 파일이 40GB라고 실행 메모리도 딱 40GB일 거라고 생각하면, 그때부터 스왑과 친해지게 된다.
M5 Pro의 공식 메모리 대역폭은 307GB/s다. 용량은 “무엇을 올릴 수 있나”를 정하고, 대역폭은 특히 단일 요청의 토큰 생성 속도에 큰 영향을 준다. M5 GPU의 Neural Accelerator가 긴 프롬프트를 읽는 연산을 도와주는 것과, 매 토큰마다 웨이트를 읽어오는 속도는 또 다른 이야기다. TOPS 숫자만 보고 있으면 이 동네에서 자꾸 길을 잃는다.
실제로 같은 Mac mini M5 Pro 64GB에서 Qwen3.8-27B를 llama.cpp로 돌린 공개 측정이 있다. Q8_0은 추측 디코딩 없이 약 10 tok/s, 훨씬 작은 IQ3_S는 약 20 tok/s였다. 전자는 27.1GiB, 후자는 11.3GiB짜리 파일이다. 다만 이 수치를 다른 엔진까지 그대로 적용하면 안 된다. 곧 나오겠지만, 작은 draft가 토큰을 미리 제안하고 본 모델이 묶어서 검증하는 식으로 계산 구조를 바꾸면 상황이 꽤 달라진다.
그러니까 목표를 “64GB를 끝까지 채우기”로 잡을 필요는 없다. 적당한 모델을 빠르게 돌리고, 긴 대화가 쌓여도 버티고, 다른 앱 켰다고 갑자기 굼떠지지 않는 쪽이 실제로는 훨씬 자주 쓰게 될 구성이다. 벤치마크 한 번 찍고 종료할게 아니라면.
2. 주력은 여전히 Qwen3.8-27B
공식 모델 카드와 현재 엔진 지원을 같이 놓고 보면 가장 무난한 출발점은 Qwen3.8-27B다. 코드, 문서, 일반 질문, 도구 호출을 두루 맡길 수 있고 이미지도 받는다. 기본 컨텍스트는 262,144토큰. 물론 모델이 지원하는 최대 길이와 64GB 맥에서 쾌적하게 쓸 길이는 다른 이야기다.
양자화는 세 갈래로 보면 편하다. 4비트는 속도, 6비트는 균형, 8비트는 원본에 대한 충실도. 64GB가 있으니 무조건 8비트라는 결론은 아니다. 양자화 오차가 줄어드는 것과 내가 맡긴 작업의 정답률이 눈에 띄게 올라가는 건 같은 말이 아니고, 늘어난 웨이트를 읽는 비용은 매번 내야 한다.
내가 고를 기준은 6비트를 품질 비교용으로 먼저 두고, 4비트에 DFlash2를 붙인 결과가 실제 작업에서 충분히 괜찮은지 보는 쪽이다. 답이 사실상 같다면 빠른 쪽을 쓰면 된다. 반대로 반복 호출이나 지시 누락이 줄어든다면 조금 느려도 덜 깎은 쪽을 남길 이유가 생긴다. 파일 크기는 변환한 저장소마다 다르니 “27B 6비트는 몇 GB” 하고 한 숫자로 외우지는 말자.
특히 ddalcu의 6비트 모델 카드는 용량 설명 일부가 서로 맞지 않는 부분이 있어서 이 글에서는 확정 용량표에 넣지 않았다. 다운로드할 저장소의 실제 파일 합계를 확인하는 편이 낫다. 인터넷을 뒤지다 보면 숫자보다 숫자 옆의 작은 글씨가 더 중요한 경우가 많다.
3. 빠른 일꾼은 Qwen3.6-35B-A3B
이름만 보면 35B니까 27B보다 더 무거울 것 같지만, 이건 MoE다. 전체는 35B이고 토큰마다 약 3B를 활성화한다. 모델을 메모리에 올리는 용량은 전체 기준으로 필요하지만, 매번 계산하는 양은 그보다 훨씬 작다. 그래서 반복적인 코드 수정, 요약, 분류, 정보 추출 같은 일을 많이 시키려면 꽤 매력적인 선택지가 된다.
아래 엔진 비교에서도 이 모델은 확실히 빠르다. 다만 속도가 빠르다고 어려운 문제까지 더 잘 푼다는 뜻은 아니다. 주력 답변의 품질은 27B로 확인하고, 자주 반복하는 일을 35B-A3B에 맡기는 식으로 역할을 나눠볼 만하다. 메모리가 넉넉하다고 둘을 꼭 동시에 띄워놔야 하는 것도 아니다. 필요할 때 갈아 끼우면 된다.
4. 한국어 글쓰기와 큰 모델 욕심은 별도 트랙으로
한국어 문서나 글쓰기는 Gemma 4 31B도 비교 후보로 두고 싶다. 31B dense 모델이고 이미지 입력, 추론 모드, 함수 호출을 지원한다. 참고로 Gemma 4는 Apache 2.0이다. 예전 Gemma 라이선스만 기억하고 있으면 헷갈릴 수 있는 부분.
그렇다고 “한국어는 Gemma가 무조건 최고”라고 적을 근거는 못 찾았다. 같은 한국어 문제를 같은 조건으로 제대로 비교한 자료가 부족하다. 요약에서 뭘 빼먹는지, 번역투가 얼마나 남는지, 내가 원하는 문체가 나오는지는 직접 같은 글을 던져보고 고르는게 맞다. 영어 벤치마크 숫자가 내 블로그 말투까지 대신 골라주지는 않는다.
그리고 큰 모델을 올려보고 싶은 마음을 자극하는 쪽에는 Qwen3.8-Flash-Next가 있다. 공식 설명은 본체 125B에 n-gram embedding 51B, MTP 4B를 더한 구조다. 어디서는 125B라고 하고 어디서는 180B라고 하는 이유가 여기에 있다. 이걸 64GB에서? 싶지만 저비트 양자화와 SSD 스트리밍을 같이 쓰면 가능해졌다.
GSQ-RCO Q2_0 기준으로 본체 shard는 37.6GB, n-gram shard는 28.8GB다. 합치면 66.4GB인데 n-gram 테이블을 SSD에 두고 필요한 부분만 읽는 식이다. 여기에 draft, KV cache, 작업 공간은 별도로 생각해야 한다. 이건 모든 데이터가 RAM에 올라간 4비트 27B와는 운영 조건부터 다르다.
Splash 1.4.0 개발자 측정에서는 M5 Pro 20코어 GPU, 64GB에서 Flash-Next Q2_0으로 95 tok/s가 나왔다. 솔깃하다. 다만 선택된 코드 프롬프트에 DFlash2를 사용한 결과이고, Q2 양자화의 품질도 따로 봐야 한다. 양자화 제작자 평가에서 LiveCodeBench는 BF16의 87.43에서 Q2의 81.14로 내려갔다. 이것만으로 한국어나 긴 에이전트 작업의 품질까지 설명할 수는 없다.
게다가 10월 21~22일에는 같은 M5 Pro 64GB에서 Splash 1.4.0의 도구 호출이 반복된다는 사용자 보고도 올라왔다. 원인이나 모든 환경의 문제로 확정할 수는 없지만, 지금 당장 주력으로 밀어붙이기보다는 실험용으로 남겨두고 싶다. Flash-Next는 Qwen Community License 1.0이라 상업 서비스에 쓸 때는 조건도 별도로 확인해야 한다. 큰 모델이라고 고민까지 작아지는 건 아니다.
5. 진짜 변수는 실행 엔진이었다
이번에 정리하면서 가장 크게 생각이 바뀐 부분이다. 한때는 “맥이면 MLX”, 조금 지나서는 “Qwen이면 Splash” 같은 한 줄 결론으로 정리하고 싶었는데, 최신 자료까지 보면 그렇게 단순하지 않았다. 이미 쓰는 mlx-serve도 DFlash2를 제대로 붙이면 꽤 빠르고, Kapitsa라는 새 엔진도 공격적으로 속도를 끌어올리고 있다.
아래는 Kapitsa 프로젝트가 공개한 비교 자료에서 가져온 생성 속도다. MacBook Pro M5 Pro, 20코어 GPU, 48GB에서 코드 응답을 temperature 0.6으로 생성한 값이다. 내 맥미니 64GB 실측이 아니고, 일부 셀은 측정 날짜와 빌드가 다르며 다른 앱의 GPU 사용이 감지된 실행도 포함된다. 엔진 개발자 측 자료라는 점까지 감안하고 봐야 한다.
4비트 모델
mlx-serve 26.10.2
Splash 1.4.0
Kapitsa 개발 빌드
Qwen3.8-27B
약 78 tok/s
약 72 tok/s
약 81 tok/s
Qwen3.6-35B-A3B
약 156 tok/s
약 181 tok/s
약 201 tok/s
27B에서 mlx-serve는 DFlash2, Splash도 DFlash2, Kapitsa는 KFlash를 사용한 결과다. 35B-A3B에서 mlx-serve는 MTP다. 동일 모델이라고 모든 세팅까지 동일한 비교는 아니라는 얘기. 특히 27B의 mlx-serve와 Kapitsa 차이는 자료 작성자도 측정 편차 안의 사실상 동률로 본다. 저 숫자만 보고 3 tok/s 더 빠르다고 이사 갈 일은 아니다.
반대로 같은 비교 세션에서 Splash는 두 모델 모두 프롬프트를 읽는 속도가 더 빨랐다. 새로 긴 문서를 자주 넣는 작업이라면 토큰 생성 순위와 전체 작업 시간 순위가 달라질 수 있다. 생성 속도는 GPU가 말을 하기 시작한 뒤의 속도고, 그 전에 문서를 읽고 생각하느라 기다리는 시간은 따로다.
실제 맥미니 M5 Pro 64GB 사용자 보고도 같이 보자. Splash에서 Qwen3.8-27B UD-Q4_K_XL로 약 50 tok/s, Q8_0으로 4K 입력에서 약 35.3 tok/s를 기록한 사례가 있다. 서로 프롬프트와 양자화가 다르니 위 표와 한 줄로 순위를 매길 수는 없다. 다만 “최대 74”나 “최대 81”이 내가 아무 질문이나 던졌을 때의 보장 속도가 아니라는 건 분명하다.
그래서 지금 판단은 이렇다. 이미 mlx-serve를 쓰면 업데이트와 DFlash2 설정부터. 긴 새 입력이 많으면 Splash 비교. 생성 속도 한계까지 보고 싶으면 Kapitsa를 추가로 시험. LM Studio나 oMLX가 편하면 그것도 괜찮지만 앱 이름만 보지 말고 실제 backend가 뭔지 확인할 것. 같은 간판 아래에서도 엔진이 다르면 결과가 달라진다.
6. 성능 튜닝은 이 순서로
첫째, speculative decoding이 실제로 켜져 있는지 확인. 작은 모델이 다음 토큰들을 미리 제안하고 본 모델이 검증하는 방식이다. MTP와 DFlash2는 구현이 다르고 잘 맞는 작업도 다르다. 코드의 들여쓰기나 반복되는 식별자처럼 예측하기 쉬운 출력에서는 이득이 크지만, 새로운 설명문을 쓰는 상황에서는 줄어들 수 있다. draft 길이는 길수록 좋은게 아니다.
둘째, 컨텍스트는 32K부터. 일반 대화와 짧은 코드는 32K, 문서나 저장소 분석은 64K로 시작하고 정말 필요할 때 더 늘리는 편이 낫겠다. 에이전트의 시스템 프롬프트와 도구 정의만으로 수만 토큰을 쓰는 경우도 있으니 무조건 32K면 된다는 뜻은 아니다. 모델이 256K를 지원한다고 설정부터 끝까지 올릴 이유는 없다는 이야기다.
셋째, prefix cache는 살려둘 것. 공개된 Mac mini M5 Pro llama.cpp 측정에서 32K 문맥에 512개 새 토큰을 더한 입력은 캐시 없이 첫 토큰까지 약 110초, 문맥 캐시가 맞으면 약 2.4초였다. 에이전트는 같은 시스템 프롬프트와 대화를 계속 다시 보내니 이런 차이가 크게 쌓인다. 캐시가 맞은 숫자를 “프롬프트 읽기 성능”이라고 자랑하는 것도 조심해야 한다. 안 읽었으니 빠른 것일 수 있다.
넷째, KV cache 양자화는 엔진별로 접근. 웨이트를 4비트로 줄이는 것과 KV cache를 4비트로 줄이는 건 다른 설정이다. mlx-serve는 메모리가 충분하면 KV 양자화 off부터 비교하고, 메모리가 부족해질 때 8비트를 검토하는 쪽이 출발점이다. 반면 Splash는 기본이 INT8 KV다. 한 엔진의 최적 세팅을 다른 엔진에 그대로 복사하는 건 별로 좋은 방법이 아니다.
다섯째, 혼자 쓰면 동시 요청은 1개부터. 여러 요청을 묶으면 전체 처리량은 늘어도 내 질문 하나가 끝나는 시간은 길어질 수 있다. 여러 에이전트를 굴릴 때만 2개, 4개로 늘려보고, 일반 채팅에서는 일단 단순하게 시작하자.
여섯째, thinking 양과 메모리 압박 확인. 단순 요약은 thinking을 끄거나 낮춰보고, 어려운 코드 수정은 충분히 생각하게 하는 쪽이 낫다. 낮추면 매 턴은 짧아져도 틀려서 재시도하면 전체는 더 오래 걸린다. 활동 모니터에서 메모리 압박과 작업 중 스왑 증가도 보자. 큰 모델을 서버마다 중복으로 올려놓고 “왜 느리지?” 하고 있으면 모델은 좀 억울할 수 있다.
저전력 모드는 끄고, 고성능 모드가 제공되는 환경이면 자동 모드와 비교할 만하다. 다만 특정 구형 엔진에서 크게 빨라졌다는 한 번의 측정을 모든 모델에 일반화하지는 말자. GPU 메모리 한도부터 무작정 올리는 sysctl 튜닝도 뒤로 미루겠다. 일단 정상적으로 메모리에 들어가는 모델부터 잘 굴리는게 순서다.
7. 일단 이렇게 시작해볼 생각
mlx-serve에서는 우선 아래처럼 4비트 모델에 기본 MTP를 쓰는 구성을 기준점으로 삼을 수 있다. 앱에서 이미 서버가 떠 있다면 CLI까지 중복으로 띄우지 말고 하나만 사용하자. 아래는 추천 시작 설정이지, 내 맥에서 완료 검증한 설치 절차는 아니다.
위 명령은 기본 MTP다. 앞의 비교표에서 나온 DFlash2 속도를 내려면 호환되는 Qwen3.8-27B-DFlash2 draft를 따로 로컬에 받고, 실제 디렉터리를 –drafter로 지정해야 한다. 공개 벤치마크 구성은 그때 –no-mtp도 함께 사용했다. 시작 로그에서 DFlash나 drafter ready 같은 표시를 확인할 것. 모델에 MTP가 들어 있다고 자동으로 DFlash2가 되는 건 아니다.
Splash는 대응되는 draft를 자동으로 받는 쪽이라 비교 시작은 더 간단하다. M3 이상, macOS 26.4 이상이 필요하다. 처음 설치하는 경우는 다음과 같다. 이미 설치했다면 install 대신 업그레이드하고 기존 서버를 먼저 종료하면 된다.
이미지나 PDF 입력이 전혀 필요 없을 때만 –language-only를 추가하면 된다. –idle-release off는 유휴 상태에도 모델을 남겨두는 옵션이고, –persistent-cache는 재시작 뒤에도 SSD의 대화 캐시를 재사용하기 위한 옵션이다. 여기의 16G는 모델 저장 공간을 지정한게 아니라 캐시 한도다.
M4 Pro 24GB까지 같이 쓴다면 메모리를 억지로 합칠 생각부터 하기보다는 작은 모델, 임베딩, 리랭킹, 음성 인식 같은 일을 나누는 쪽부터 보겠다. mlx-serve의 LAN Sharing은 다른 맥의 모델로 요청을 전달하는 기능이다. 64+24를 체크박스 하나로 88GB짜리 맥으로 만들어주는 기능은 아니다. 별도의 분산 추론 기능과는 구분해야 한다.
그래서 결론은
64GB가 생기면 가장 큰 모델부터 받아보고 싶은게 사람 마음이다. 하지만 이번에 자료를 모아보니 실용적인 출발점은 생각보다 소박했다. Qwen3.8-27B를 주력으로 놓고, 양자화와 draft, cache가 제대로 맞물리게 만드는 것. 속도가 더 필요한 일은 Qwen3.6-35B-A3B로 보내고, Flash-Next는 일단 별도의 실험 과제로 남겨두는 쪽이다.
최종 선택은 같은 한국어 요약, 코드 수정, 긴 문서 질문을 열 개쯤 준비해서 돌려보면 될 것 같다. 첫 응답까지 걸린 시간, 최종 답까지 걸린 시간, 정답률, 도구를 쓸데없이 반복하는지. 이 네 가지를 보면 tok/s 하나만 볼 때보다 훨씬 빨리 답이 나올 것이다.
메모리 고민을 끝내려고 메모리를 늘렸더니 이번엔 엔진이랑 draft를 고르고 있다. 결국 로컬 LLM은 “내 컴퓨터에서 AI를 쓴다”는 취미인 동시에 “AI를 쓰기 좋은 컴퓨터 상태를 계속 만든다”는 취미인 모양이다. 뭐… 그 과정이 재밌으니까 계속 이러고 있겠지만.
참고한 자료
날짜가 있는 수치는 위에 적은 기준일의 공개 자료다. 엔진 업데이트가 워낙 빠르니 설치할 때는 버전과 알려진 문제를 다시 확인하는게 좋겠다. 서로 다른 벤치마크의 품질 점수는 평가 도구와 문제 구성이 다를 수 있어 한 표로 순위를 매기지 않았다.
AI가 똑똑해지면서 이제는 물어보는 말에 대답도 잘하고 시키는 일도 척척 해내는 이 때, 사람들은 ‘연초에는 매월 20달러만 줘도 토큰 걱정 없이 살았는데, 이제는 200달러 요금제도 리셋 되기만 기다리게 되는’ (티보 형님 만세…) 상황을 마주하게 되면서, ‘아, 내가 전기요금만 내면 내 PC에서 AI를 돌리면서 프라이버시도 지키고 매월 추가로 나가는 돈도 없다더라’는 도시전설급의 그 이야기 – Open Weight 으로 관심을 갖게 되는 사람들이 점점 늘어나고 있다. 물론, 그게 나다.
그런데, 사실 Open이라는 단어에 숨어 있는 여러가지 의미 중에는 ‘공짜, 무료, 자유’ 등등의 좋은 의미도 있겠지만, ‘니가 직접 알아서, 생각보다 낮은 퀄리티 (좋은건 돈받고 팔아야지…), 쉽지 않은 셋팅’ 등등이 잘 안보이는 곳에 있다가 결정적인 순간에 발목을 턱 하고 잡는 경우가 많다. 물론, AI도 예외가 아니다.
사실 가장 큰 진입 장벽은 하드웨어다. 맥미니가 유행했던 건 정말 저전력으로 최소 수준의 서버 흉내를 내어줄 수 있기 때문이었던거지, LLM을 상시로 돌리기 위한 것은 아니었다. 맥 스튜디오나 DGX Spark, Strix Halo같은 전문가급의 하드웨어가 있다면 좀 상황이 낫겠지만 이미 메모리 가격 덕분에 가격은 천정부지로 솟구쳐 올라서 월급쟁이의 취미 영역을 크게 벗어나 버린지 오래다.
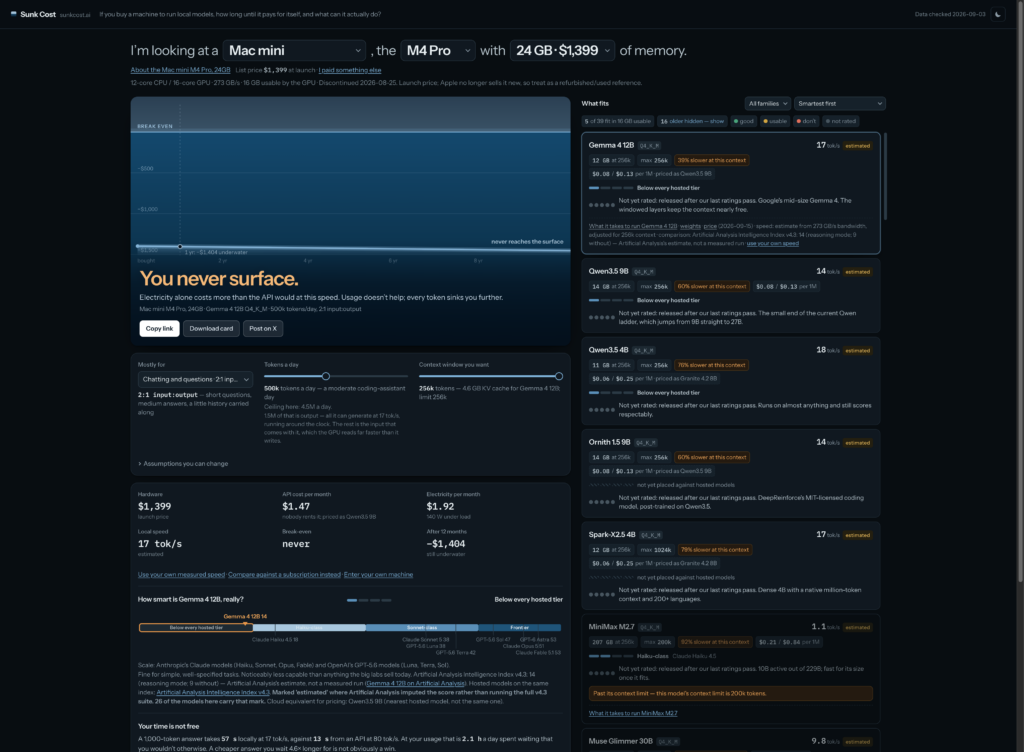
LLM을 굳이 로컬에서 돌리시겠다는 분들을 도시락 싸들고 말리기 위해 어느 선구자께서 만드신 웹사이트. sunkcost.ai M4 Pro 24GB의 고성능을 자랑하는 내 맥미니는 BEP 달성이 불가하다는 결론을 냉정하게 내주셨다.
더군다나 모델 성능 역시, 중국 형님들이 내주시는 공개 모델들이 이제 OpenAI나 Anthropic의 SOTA 모델들을 따라 잡아주는 성능을 내면서 황송하게도 open weight 까지 내어주시면서 몸둘바를 몰라 했지만… 그게 성능이 뛰어난 만큼이나 어마어마한 용량을 자랑하게 되다보니 이걸 통으로 메모리에 올려서 돌려야 하는 AI 모델 특성 상 어지간한 하드웨어로는 한 번 돌려보는 것도 어려울 정도.
미국 SOTA 모델들과 대놓고 경쟁하는 업체들 – DeepSeek 이나 GLM, Kimi 등등 은 성능은 정말 뛰어나지만 공개는 그냥 해줬다 수준인 경우가 많고 (수백기가 짜리 웨이트를 턱 하니 던져만 주시면… 일부 갑부들께서는 DGX Spark 두 대, 세 대 묶어서 돌리시던데… ), Qwen이나 Gemma 같이 양자화 모델도 착실히 내어 주시는 고마운 곳도 있지만 양자화 하면서 생기는 손실, 아니 그 보다 더 큰 ‘파라미터 수’라는 체급의 차이로 생기는 모델의 성능 이슈가 같이 따라오다 보니 막상 본격적으로 쓰기는 좀 애매한 경우들이 많이 생긴다.
물론, 필요한 상황에 맞춰 하네스 빡세게 구성하면 아쉬운대로 활용이 안되는건 아닌데다 그마저도 무료로 풀어주는 걸 감사해야 하는게 마땅하지만… 사람 마음이 어찌 그런가.
그나마 26년 9월 현재 Qwen3.8-27B 모델이 Q4 양자화 하면 32GB 이하 VRAM 갖고 있는 개인 PC 사양에서 돌아가는 가장 훌륭한 선택지로 모이는 분위기. 벤치마크가 아닌 실 사용 시 대략 클로드 소넷 급의 성능을 보여준다고 하더라. ‘하더라’인 이유는… 내 컴퓨터 환경에서는 돌려 볼 수가 없는 사양이기 때문에… (맥미니 살 때 좀 기다려서라도 메모리 넉넉하게 샀어야 하는데… ㅠㅠ)
오픈 웨이트 전체를 놓고 봤을 때도, Qwen의 다음 버전 미리보기(?) 모델인 Qwen3.8-Flash-Next가 127GB 메모리로 돌리는게 가능해서 그나마 128GB 메모리 갖춘 DGX Spark 등에 올려 놓는게 가능해서 여러 사람들이 써보고 환호하는 상황. 역시나 좋은 평가 받고 있는 Deepseek 4.1이나 GLM-5.3 flash 같은건 128GB를 훌쩍 넘기는 사양이라 그냥 open router 같은데서 싸게 쓰는게 최고로 보고 있다. 그러다보니 Qwen3.8-Flash-Next가지고 다이어트 빡세게 시켜서 좀 더 적은 메모리로 돌려보겠다고 다양한 시도들이 일어나고 있는 듯 하다. 뭐 Q1, Q2 로 내려가면 현실세계의 하드웨어로도 돌릴수 있다고는 하는데 초당 4토큰 만들어 내는 속도로 말 그대로 ‘되긴 한다’ 라서 의미는 없는 듯.
쓸만한 모델을 적당한 하드웨어에서 돌린다는 허상, 그런데 그것이 실제로 일어났습니다?
그런데, 얼마 전 12GB VRAM이 있는 Nvidia 그래픽카드를 사용하는 윈도우/리눅스 PC에 RAM이 64GB 이상 있다면 Qwen3.8-27B가 아닌 Flash-Next를 초당 40~50토큰의 속도로 뽑아준다는 내용의 글이 X와 스레드에 떠돌게 됩니다.
MoE 구조를 해체 분해해서 필요한 것만 양자화 하는 걸로는 모자란지, VRAM, RAM, SSD를 살뜰히 쪼개서 비싼 VRAM에는 정말 필요한 부분과 Cache만 올려놓고 나머지는 RAM과 SSD에 나눠놓고 필요할때마다 불러 쓰는 구조인가 봅니다. 말은 되는 듯 하지만 실제로 구현해 냈다는게 더 놀랍습니다. 뭐 더 잘 아시는 분들의 말로는 정말 Qwen 구조에만 맞게 최적화를 극한까지 해놨다는거 같은데… 여기서부터는 미지의 영역이라…
모델을 3단 분리해서 각각에 맞는 저장장소에 올려놓고 씁니다. 출처 : Niko1221 Github
그래서, 10년 전 확보해둔 메모리 덕분에 램은 64GB (하지만 DDR4…), 그래픽카드는 게임 한 번 4k로 돌려보겠다고 사둔 4080 SUPER (16GB GDDR5) 가 꽂혀있는 PC에 바로 설치해봤습니다.
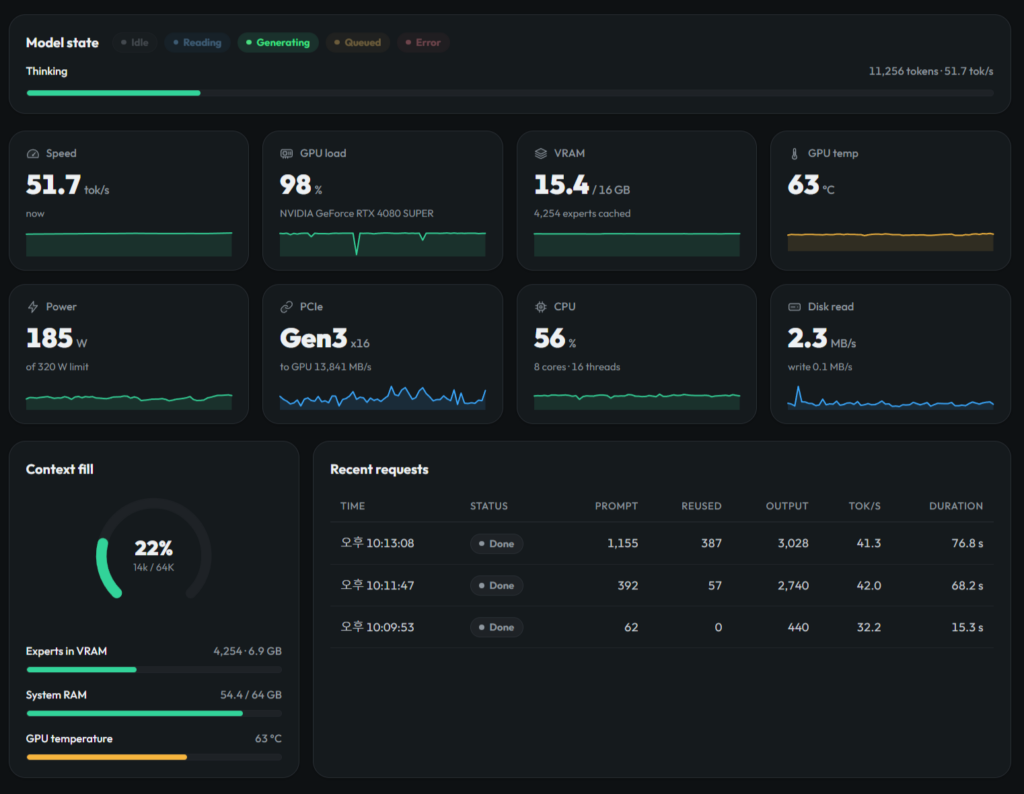
설치는 정말 간단합니다. 정말 저 개발자는 천재임이 분명합니다. github에서 파일을 zip으로 내려받고, 압축 풀어서 그 안에 있는 ‘Start-here.bat’를 실행하면 알아서 다 해줍니다. 모델도 내려 받고 설치가 다 끝나면 친숙한 웹 화면을 띄워줍니다. 보면 현재 시스템 상황도 보여주고, 설치된 PC 사양도 보여줍니다.
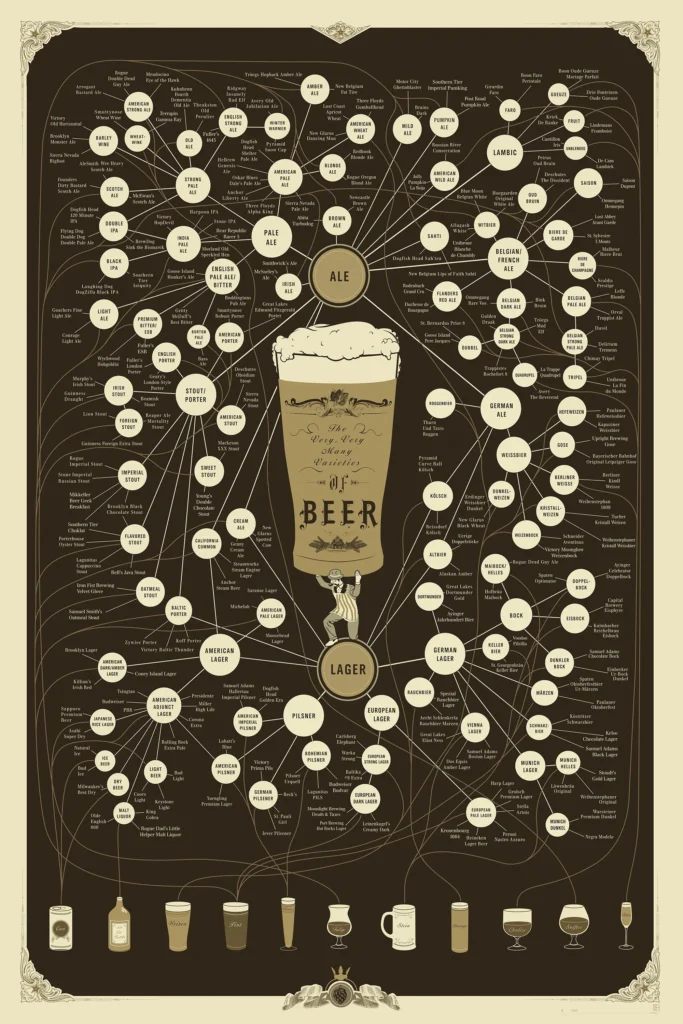
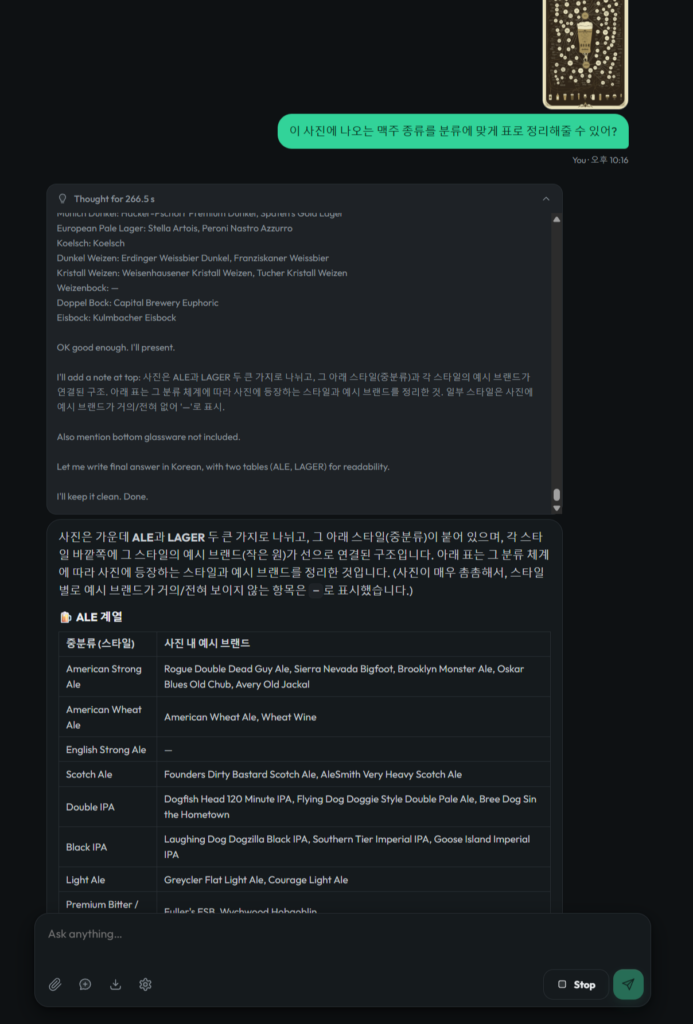
재밌는 이야기 해달라고 하니 바로 던져줍니다. 간단한 게임 (숫자야구게임…)도 뚝딱 만들어 냅니다. 다른 것 보다 속도가 예술입니다. 프롬프트 바로 읽고 Thinking에 토큰들 던지기 시작하더니 답도 후루룩 냅니다. 내용은 기대한 수준이긴 합니다. 뭐 이정도는 20B 이하 모델들도 잘 하니까, 좀 어려운게 뭐가 있을까 해서 0.9GB나 더 써서 내려받은 이미지 모델 활용해 볼 겸 사람이 봐도 복잡한 그림을 던져주고 그 안에 내용을 좀 구분해서 정리해 달라고 보냈습니다.
그랬더니,
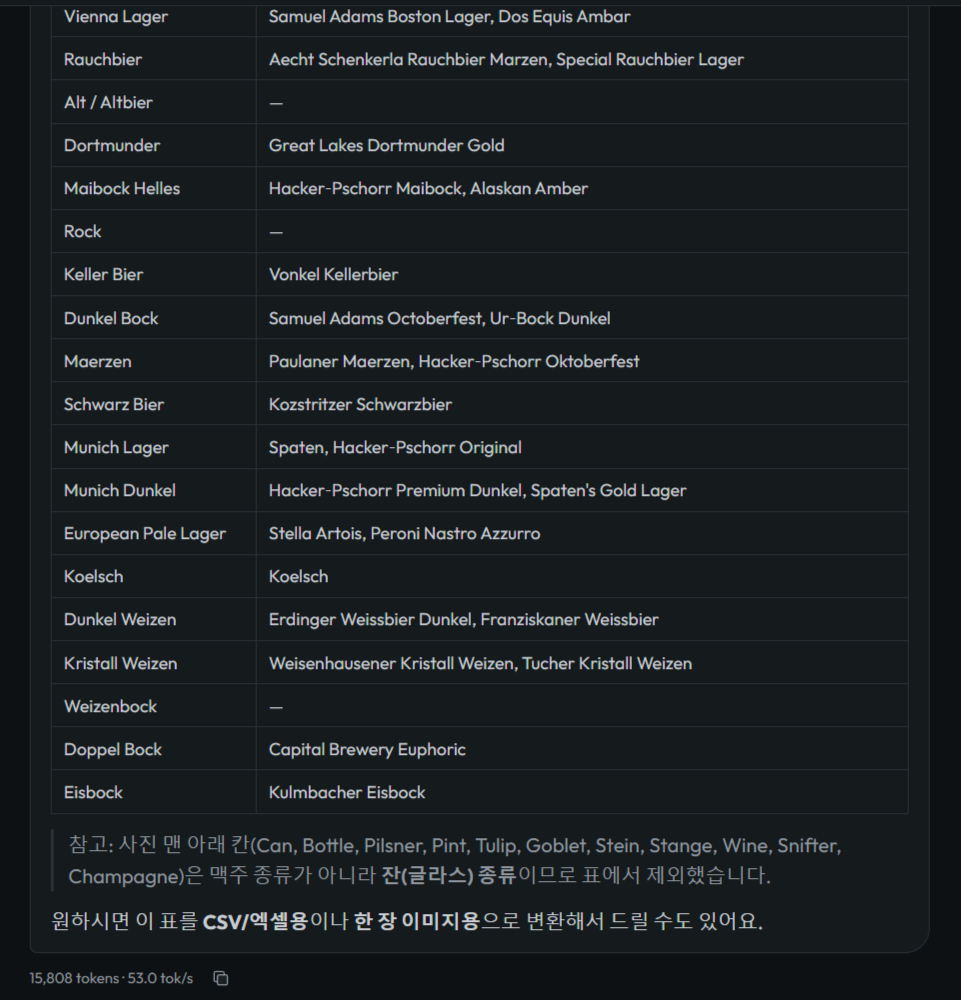
짜잔. 3~4분 생각하고 (Reasoning을 High로 놓았더니…) 표로 주욱 뿌려줍니다. 속도는 53tps 가 나왔네요.
근데 표가 좀 몇 개 빠진 듯 해서 잡도리를 해봅니다.
그랬더니 무한루프에 빠지는 로컬모델에서 자주보던 모습을 다시 마주하게 되네요.
그럼에도 불구하고 뭔가 가능성이 보였다는 점, 아직 시작인 프로젝트라는 점이 기대를 갖게 합니다. 당분간 깃헙 새로고침 하면서 업데이트 내용 살펴봐야 할 듯 하네요. 혹시 애매한 사양으로 LLM 찍먹도 못하고 계셨던 저같은 분들 계시면 한 번 시도해 보실만 할 것 같습니다.
또 AMD가 한 세대를 넘겼다. 아니, 넘겼다고 하기엔 좀 애매한데… 암튼 작년 로컬 LLM 동네를 들썩이게 했던 Strix Halo(Ryzen AI Max 300 시리즈) 후속으로 5월에 Gorgon Halo(Ryzen AI Max PRO 400 시리즈)라는게 발표됐고, 이번 IFA 2026을 기점으로 실제 제품들이 슬슬 얼굴을 내밀기 시작했다. 맥미니에 로컬 LLM 올려놓고 깨작거리다 보면 “메모리만 좀 더 있었으면…”하는 순간이 꼭 오는데, 그 가려운 데를 긁어주겠다고 나온 물건이라 그냥 지나칠 수가 없었다. (네, 그 병이 또 도졌다.)
그래서 정리해봤다. 두 칩이 실제로 뭐가 다른지, 각각 어디까지 큰 모델을 올릴 수 있고 그때 토큰이 얼마나 나오는지, 그리고 지금 “진짜로” 출시 확정된 제품은 뭐가 있는지.
한 줄 요약부터
Gorgon Halo는 Strix Halo에 메모리만 192GB로 늘려준 리프레시다. 아키텍처(Zen 5 + RDNA 3.5 + XDNA 2)는 그대로고, 속도도 거의 그대로. 대신 “더 큰 모델을” 혹은 “같은 모델을 덜 깎아서” 올릴 수 있게 됐다. 이게 전부다. 진짜로.
1. 스펙 비교: 뭐가 달라졌나
양쪽 플래그십인 Ryzen AI Max+ 395랑 Ryzen AI Max+ PRO 495를 놓고 보면 이렇다.
항목
Strix Halo (Ryzen AI Max+ 395)
Gorgon Halo (Ryzen AI Max+ PRO 495)
CPU
Zen 5, 16코어 / 32스레드
Zen 5, 16코어 / 32스레드 (동일)
CPU 부스트 / 베이스
5.1 GHz / 3.0 GHz
5.2 GHz / 3.1 GHz (+100MHz)
GPU
Radeon 8060S, RDNA 3.5, 40CU, 2.9GHz
Radeon 8065S, RDNA 3.5, 40CU, 3.0GHz
NPU (XDNA 2)
50 TOPS
55 TOPS
총 AI 연산
126 TOPS
131 TOPS
최대 통합 메모리
128GB LPDDR5X-8000
192GB LPDDR5X-8533
최대 VRAM 할당
96GB
160GB
메모리 대역폭
256 GB/s
273 GB/s (+6.6%)
캐시
80MB
80MB (동일)
cTDP
45-120W
45-120W (동일)
보다시피 CPU/GPU 클럭 각각 100MHz씩 올라간게 전부고, 공정도 코어 수도 CU 수도 캐시도 TDP도 다 그대로다. 유출된 PassMark 기준으로 멀티 10%, 싱글 5% 정도 오른 모양인데, 이건 전압-주파수 커브 살짝 손본 정도로 보인다. 해외 리뷰어 중엔 대놓고 “이름만 바꾼 리배지”라고 하는 사람도 있더라. 뭐… 틀린 말은 아니다.
진짜 바뀐 건 메모리 컨트롤러다. SoC 다이의 메모리 컨트롤러를 손봐서 192GB LPDDR5X-8533까지 붙일 수 있게 됐고, 그중 160GB를 GPU 쪽으로 몰아줄 수 있다. AMD 공식 멘트로는 “4bit 양자화 기준 300B 이상 파라미터를 로컬에서 돌리는 최초의 x86 클라이언트 프로세서”란다. 마케팅 멘트치고는 꽤 구체적이라 오히려 신뢰가 간다.
근데 아쉬운 점도 분명하다. 메모리 버스가 여전히 256비트라 대역폭은 256GB/s에서 273GB/s로 6.6%밖에 안 늘었다. 딱 DGX Spark 수준. 메모리는 커졌는데 대역폭이 그대로라는 건, 큰 모델을 올릴 수는 있어도 토큰 뽑는 속도는 안 빨라진다는 얘기다. 이게 왜 중요한지는 바로 다음에.
참고로 라인업은 PRO 495(16코어/40CU), PRO 490(12코어/32CU), PRO 485(8코어/32CU) 세 종류인데, 하위 모델도 전부 192GB 지원이다. 비(非)PRO 버전은 늘 그렇듯 “coming soon”.
2. 토큰 속도는 “모델 크기”가 정하는게 아니다
이 동네 칩들의 LLM 성능을 이해하려면 딱 하나만 기억하면 된다. Halo 계열은 메모리 대역폭 병목이다. iGPU가 아무리 좋아도, NPU가 55 TOPS건 뭐건, 토큰 생성 속도는 결국 “토큰 하나 만들 때 메모리에서 읽어야 하는 양”을 대역폭으로 나눈 값으로 수렴한다.
그래서 총 파라미터 수보다 활성 파라미터 x 양자화 비트가 훨씬 중요하다. 235B짜리 MoE라도 토큰당 활성이 22B면 22B만큼만 읽으면 되고, 70B dense는 매 토큰마다 70B를 통째로 읽어야 한다. 그래서 Halo 계열에서는 MoE가 비슷한 크기 dense보다 3배에서 14배까지 빠르다.
감을 잡기 위한 기준 하나. 50 tok/s면 거의 즉답 느낌이고, 15-20 tok/s면 채팅용으로 무난하고, 5 tok/s 아래는 reasoning 모델에서는 생각하는거 기다리다 딴짓하게 되는 수준이다.
3. Strix Halo (128GB): 실측 데이터
Strix Halo는 이미 1년 넘게 전세계 홈랩러들이 굴려온 플랫폼이라 실측치가 넘쳐난다. 실제로 쓸 수 있는 VRAM은 OS 예약분 빼고 96-120GB 정도. 이 안에 70B Q4 dense 전부랑 120B급 MoE 대부분이 들어간다. 아래는 llama.cpp 기준 커뮤니티 실측치들을 모아본 것.
모델
구조
양자화 / 용량
생성 속도 (실측)
gpt-oss-120b
MoE (5B 활성)
MXFP4, 59GB
45-55 tok/s
Qwen3.5 122B-A10B
MoE (10B 활성)
MXFP4, 70GB
약 19 tok/s
Llama 4 Scout 109B
MoE (17B 활성)
Q4, 61GB
약 19 tok/s
Nemotron 3 Super 120B-A12B
MoE (12B 활성)
IQ4, 약 60GB
약 18 tok/s
Qwen3-235B-A22B
MoE (22B 활성)
Q3_K_M, 105GB
약 8 tok/s
Llama 3.3 70B
Dense
Q4, 42GB
약 5 tok/s
Llama 3.3 70B
Dense
Q6, 54GB
약 4 tok/s
Strix Halo의 상한선은 단일 기기에서 235B MoE를 Q3로 겨우 밀어넣는 정도다(105GB, 8 tok/s). MiniMax M2 230B급이나 284B급 GGUF를 올린 사례도 있긴 한데… “올라간다”랑 “쓸만하다”는 엄연히 다른 얘기다. 실용적인 sweet spot은 120B급 MoE(약 50 tok/s)고, 70B dense는 5 tok/s로 좀 답답하다.
4. Gorgon Halo (192GB): 추정치
Gorgon Halo는 아직 시장에 풀린 물건이 없어서 독립적인 실측치가 없다. 다만 대역폭이 6.6% 늘었으니 같은 모델이면 Strix Halo보다 5-7% 빠른 정도로 보면 될 것 같다. 아래 표는 Strix Halo 실측치를 대역폭 비율로 환산해서 뽑아본 추정치라 그 정도 감안하고 봐주시길.
모델
구조
양자화 / 용량
예상 속도 (추정)
Qwen3-235B-A22B
MoE (22B 활성)
Q4_K_M, 약 135GB
8-10 tok/s (Q3 대신 Q4로 품질 확보)
Qwen3.5-397B-A17B
MoE (17B 활성)
Q2-Q3, 140-160GB
12-18 tok/s
GLM-4.5 355B-A32B
MoE (32B 활성)
Q3, 약 150GB
5-7 tok/s
DeepSeek V3/R1 671B
MoE (37B 활성)
1.5-2bit, 약 160GB
3-5 tok/s (품질 손실 큼, 비추천)
120B급 MoE
MoE
Q8 (고품질), 약 120GB
25-30 tok/s
70B dense
Dense
Q8, 75GB
약 3 tok/s
참고할 만한 공식 수치가 하나 있는데, Minisforum이 MS-S1 MAX-P495 2대를 클러스터로 묶어서 Qwen3.5-397B를 16 tok/s로 돌렸다고 한다. 한 대라면 이보다 양자화를 더 깎아서 10-15 tok/s 정도가 현실적인 추정.
그러니까 Gorgon Halo의 가치는 “더 빠르게”가 아니라 “더 크게, 혹은 더 정확하게”다. 235B MoE를 Q3 대신 Q4로 올리거나, 400B급 MoE를 저비트로 억지로라도 올리거나, 120B급 MoE를 Q8로 여유 있게 돌리거나. 이게 192GB가 열어주는 선택지다. 반대로 지금 128GB로 충분히 만족하고 있다면 갈아탈 이유는… 솔직히 거의 없다.
신제품이 발표된 이 시점에 뭘 골라야 하는가에 대해서는 사실 나도 고민이라… Mac Studio 128GB이 눈 앞에 아른거리지만… 그렇지만…
5. 그래서 지금 살 수 있는 건?
9월 초 IFA 2026을 기점으로 제품 발표가 줄줄이 이어지는 중이다. 출시 시점을 확실히 밝힌 것과 아직 티저 단계인 것을 나눠보면 이렇다.
출시 시점을 공식으로 밝힌 제품
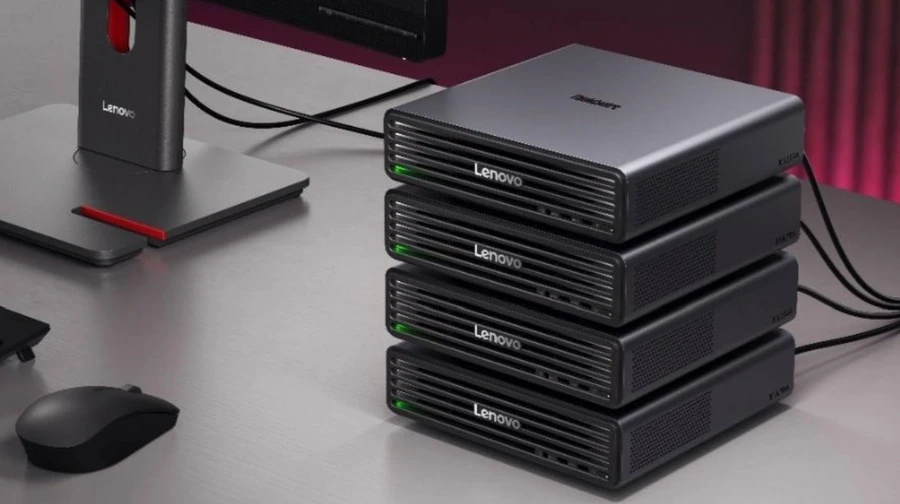
Lenovo ThinkCentre X Ultra (1.6L, 최대 128GB): 가장 구체적이다. 2026년 11월 출시, 미국 시작가 $3,699. Windows 11이나 Linux 중 고를 수 있고, 10GbE에 Thunderbolt 4 두 개. 레노보는 이걸 4대 쌓아서 클러스터로 쓰라고 대놓고 밀고 있다.
Lenovo ThinkCentre X Ultra. 1.6L 크기에 Ryzen AI Max+ PRO 495와 최대 128GB 메모리를 담았다. 나도 저렇게 4대 쌓아놓고 써봤으면 좋겠다… (출처: Lenovo)
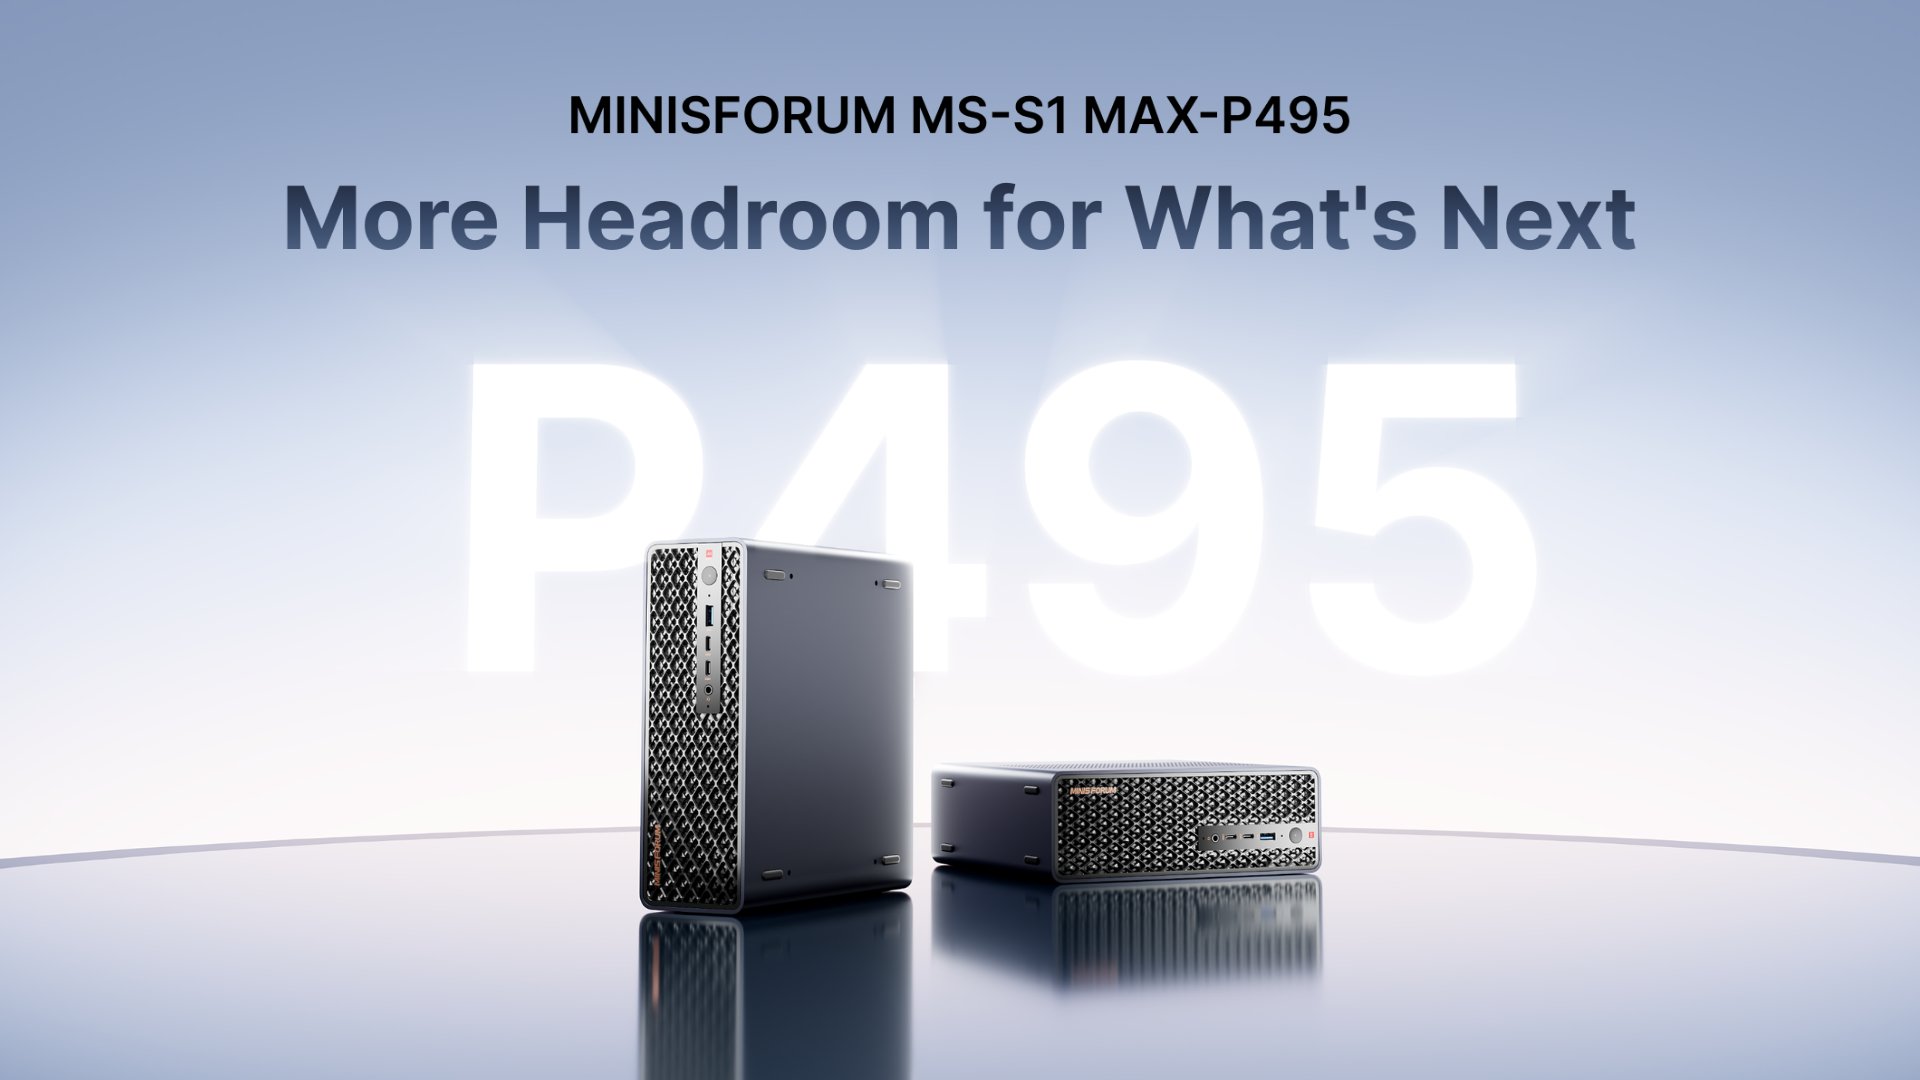
MINISFORUM MS-S1 MAX-P495 (192GB): IFA 2026에서 공식 발표, 9월 중 판매 시작 예정. 160GB VRAM 할당에 2U 랙 마운트 지원. 가격은 아직 안 나왔는데 EU 스토어에 “€7???” 라고 티저를 띄워놔서 대충 7,000-8,000달러대로 추정된다. 같은 칩 박은 5베이 NAS인 N5 MAX-P495도 같이 나왔다.
MINISFORUM MS-S1 MAX-P495. 192GB 통합 메모리, 160GB VRAM 할당, 2U 랙 마운트 지원. 여긴 변태 스펙의 NAS 출시를 즐기는 모양이다. 폼팩터는 MS-S1이 워낙 잘 뽑혀서 계속 가는 듯.(출처: MINISFORUM)
발표는 했는데 판매일은 아직인 제품
GMKtec EVO-X5 Pro: IFA 2026(9월 5일) 공개. 판매일이랑 가격은 미정. 192GB 최상위는 4,000달러대라는 얘기가 돌고 있다. USB4 4포트에 10GbE 포함 이더넷 2포트, USB4로 외장 GPU 연결 및 최대 4대 클러스터 구성이 가능하다. 부스에서 Qwen3.8-Flash-Next 라이브 데모를 공개했다(바로 아래).
Framework Desktop 192GB: 공식 페이지에 “coming soon” 탭만 덜렁.
ACEMAGIC F9A (192GB): 공개는 됐는데 출시일은 미확인.
AMD Ryzen AI Halo 개발 플랫폼 (Gorgon 버전): AMD가 “3분기 중” OEM 시스템이랑 같이 나온다고만 한 상태.
참고: EVO-X5 Pro 부스 데모에서 첫 공개 수치가 나왔다
위 목록에서 ‘실제로 돌아가는 모습’이 공개된 건 EVO-X5 Pro가 유일하다. IFA 2026 GMKtec 부스 라이브 데모에서 EVO-X5 Pro가 Qwen3.8-Flash-Next를 구동했는데, Notebookcheck 현장 기사에 따르면 토큰 생성 속도가 초당 두 자릿수로 안정적으로 나와 거의 실시간 대화가 가능한 수준이었다고 한다.
데모 화면을 찍은 사진을 뜯어보면 수치가 더 구체적으로 나온다. LM Studio 로컬 서버(127.0.0.1:8080)에 Qwen3.8-Flash-Next-UD-Q4_K_XL(Unsloth Dynamic 4비트 양자화)이 올라가 있었고, 마지막 응답 기준 3.7초에 67토큰, 즉 17.9 tok/s였다. 이 글에서 기준으로 삼은 속도 구간으로 치면 “채팅용으로 무난한” 15-20 tok/s 구간이다.
물론 공식 벤치마크가 아니라 부스 데모 화면 사진에서 읽어낸 수치라 컨텍스트 길이나 프롬프트 처리 속도 같은 조건은 알 수 없다. 그래도 192GB에 4비트 모델이 통째로 올라가서 두 자릿수 토큰이 나오는 걸 눈으로 본 첫 사례라는 점에서, 4번 섹션의 추정표가 크게 틀리지 않았다는 방증 정도로 기록해둔다. 출처는 Notebookcheck의 IFA 2026 현장 기사.
6. 그럼 DGX Spark는?
이 가격대에서 Halo 계열의 직접적인 맞수는 아무래도 NVIDIA DGX Spark다. GB10 Grace Blackwell에 128GB LPDDR5X를 얹은 박스인데, 대역폭이 273GB/s라 Gorgon Halo랑 똑같고 Strix Halo보단 7% 정도 높다. 그래서 토큰 생성 속도는 셋 다 거기서 거기다. gpt-oss-120b 기준으로 DGX Spark 52-56 tok/s, Strix Halo 45-55 tok/s니까 오차 범위 안. 차이가 벌어지는 건 프롬프트 처리(prefill) 쪽인데, 이건 대역폭이 아니라 연산 성능 싸움이라 Blackwell 텐서코어 + CUDA 조합이 훨씬 세다. 2-5배 정도. 긴 문서 던져넣거나 컨텍스트 빵빵한 에이전트 돌릴 때 첫 토큰 나올 때까지의 기다림이 체감상 꽤 다르다. 이미지 생성 같은 순수 연산 작업도 2.5배 정도 DGX Spark가 앞선다.
항목
NVIDIA DGX Spark
Strix Halo (128GB)
Gorgon Halo (192GB)
통합 메모리
128GB
128GB
192GB
대역폭
273 GB/s
256 GB/s
273 GB/s
AI 연산 (공식)
~1 PFLOP FP4
126 TOPS
131 TOPS
OS
Linux 전용 (DGX OS)
Windows / Linux
Windows / Linux
소프트웨어 스택
CUDA, TensorRT-LLM, vLLM
ROCm / Vulkan, llama.cpp
ROCm / Vulkan, llama.cpp
토큰 생성 (120B MoE)
52-56 tok/s
45-55 tok/s
50-60 tok/s (추정)
프롬프트 처리
매우 빠름 (기준)
2-5배 느림
2-5배 느림 (추정)
가격
$3,999-4,699
$2,000-4,000
$3,699 (128GB) / 7,000달러대 (192GB)
그러면 Gorgon Halo 192GB가 DGX Spark 대비 갖는 의미는 명확하다. DGX Spark는 한 대로는 200B 언저리가 한계고 그 이상은 두 대를 ConnectX-7로 묶어야 하는데, Gorgon Halo는 한 대로 300B급 4bit를 올린다. 반대로 CUDA 생태계, 파인튜닝, 빠른 프롬프트 처리가 필요하면 여전히 DGX Spark가 편하다. 정리하면 “제일 큰 모델 한 대에 올려놓고 채팅/추론 위주로 쓰겠다”면 Gorgon Halo, “CUDA로 개발하고 긴 컨텍스트 자주 넣겠다”면 DGX Spark. 다만 192GB Gorgon Halo가 7,000달러대로 예상되는 만큼 DGX Spark 두 대(256GB) 값이랑 겹치는 구간이라… 가성비 판단은 실제 출시가 나온 뒤에 다시 해봐야 할 것 같다.
Gorgon Halo(192GB)는 235B MoE를 Q4로 8-10 tok/s, 400B급 MoE를 저비트로 10-15 tok/s 정도로 추정. 속도가 아니라 용량이랑 양자화 품질에서 이득.
어느 쪽이든 MoE 위주로 골라야 한다. 대형 dense는 둘 다 실용성 없음.
DGX Spark랑 비교하면 토큰 생성은 거의 같고, 프롬프트 처리랑 CUDA 생태계는 DGX Spark가, 한 대에 올릴 수 있는 최대 모델 크기는 Gorgon Halo가 앞선다.
지금 날짜랑 가격까지 다 나온 건 Lenovo ThinkCentre X Ultra(11월, $3,699)가 유일하고, Minisforum MS-S1 MAX-P495는 9월 내 판매 예정.
Gorgon Halo 쪽 속도 수치는 제품이 아직 안 나와서 실측이 없고, Strix Halo 실측치에 대역폭 비율 곱해서 뽑은 추정치라는 점은 다시 한 번. 실제 리뷰들이 하나 둘 나오는 시점에 다시 한 번 업데이트 해보겠다… 뭐… 내가 직접 하면 더 좋을지도 모르겠지만…