맥미니 M5 Pro 64GB로 로컬 LLM 돌리기: 메모리를 늘렸더니 이번엔 엔진이 문제다

지난 Strata 글에서 맥미니 살 때 메모리를 좀 넉넉하게 샀어야 했다고 한탄을 했었다. M4 Pro 24GB로 로컬 LLM을 만지다 보면 꼭 그 생각이 든다. 모델은 좋은데 안 들어가고, 들어가는 걸 고르면 뭔가 아쉽고. 그래서 메모리만 늘리면 이 고민이 끝날 줄 알았는데…

이번에는 맥미니 M5 Pro 64GB를 기준으로 뭘 올리는게 가장 나을지 정리해봤다. 결론부터 말하면, 메모리가 늘어나니 이제는 양자화랑 실행 엔진을 고르는 고민이 시작된다. 이 취미는 정말 친절하다. 다음 고민거리를 끊임없이 공급해준다.

먼저 선을 하나 긋고 시작하자. 이 글은 2026년 10월 23일까지 공개된 공식 문서와 벤치마크, 사용자 보고를 모아본 정리다. 아래 속도는 내 맥미니에서 직접 재서 만든 사용기가 아니다. 특히 개발자가 올린 최고 기록이랑 실제 사용자 보고를 섞어서 “내 컴퓨터에서도 이 속도 나온다”고 읽으면 곤란하다. 그 부분은 가능한 한 나눠 적었다.

한 줄 요약부터

모델 하나만 고르면 Qwen3.8-27B. 품질과 속도의 균형은 6비트, 빠른 코딩은 4비트에 DFlash2, 처리 속도를 더 챙기고 싶으면 Qwen3.6-35B-A3B. 그리고 이미 mlx-serve를 쓰고 있다면 일단 그걸 제대로 세팅하는게 먼저다. 새 엔진 나왔다고 매번 이사부터 갈 필요는 없다. 물론 구경은 해야겠지만…

1. 64GB면 큰 모델부터 올려야 하는거 아닌가

일단 메모리가 64GB라고 해서 모델에 64GB를 몽땅 줄 수 있는 건 아니다. macOS도 먹고 살아야 하고, 모델 웨이트 외에 KV cache, 추론용 작업 공간, speculative decoding에 쓰는 작은 draft 모델도 자리를 차지한다. 다운로드 파일이 40GB라고 실행 메모리도 딱 40GB일 거라고 생각하면, 그때부터 스왑과 친해지게 된다.

M5 Pro의 공식 메모리 대역폭은 307GB/s다. 용량은 “무엇을 올릴 수 있나”를 정하고, 대역폭은 특히 단일 요청의 토큰 생성 속도에 큰 영향을 준다. M5 GPU의 Neural Accelerator가 긴 프롬프트를 읽는 연산을 도와주는 것과, 매 토큰마다 웨이트를 읽어오는 속도는 또 다른 이야기다. TOPS 숫자만 보고 있으면 이 동네에서 자꾸 길을 잃는다.

실제로 같은 Mac mini M5 Pro 64GB에서 Qwen3.8-27B를 llama.cpp로 돌린 공개 측정이 있다. Q8_0은 추측 디코딩 없이 약 10 tok/s, 훨씬 작은 IQ3_S는 약 20 tok/s였다. 전자는 27.1GiB, 후자는 11.3GiB짜리 파일이다. 다만 이 수치를 다른 엔진까지 그대로 적용하면 안 된다. 곧 나오겠지만, 작은 draft가 토큰을 미리 제안하고 본 모델이 묶어서 검증하는 식으로 계산 구조를 바꾸면 상황이 꽤 달라진다.

그러니까 목표를 “64GB를 끝까지 채우기”로 잡을 필요는 없다. 적당한 모델을 빠르게 돌리고, 긴 대화가 쌓여도 버티고, 다른 앱 켰다고 갑자기 굼떠지지 않는 쪽이 실제로는 훨씬 자주 쓰게 될 구성이다. 벤치마크 한 번 찍고 종료할게 아니라면.

2. 주력은 여전히 Qwen3.8-27B

공식 모델 카드와 현재 엔진 지원을 같이 놓고 보면 가장 무난한 출발점은 Qwen3.8-27B다. 코드, 문서, 일반 질문, 도구 호출을 두루 맡길 수 있고 이미지도 받는다. 기본 컨텍스트는 262,144토큰. 물론 모델이 지원하는 최대 길이와 64GB 맥에서 쾌적하게 쓸 길이는 다른 이야기다.

양자화는 세 갈래로 보면 편하다. 4비트는 속도, 6비트는 균형, 8비트는 원본에 대한 충실도. 64GB가 있으니 무조건 8비트라는 결론은 아니다. 양자화 오차가 줄어드는 것과 내가 맡긴 작업의 정답률이 눈에 띄게 올라가는 건 같은 말이 아니고, 늘어난 웨이트를 읽는 비용은 매번 내야 한다.

내가 고를 기준은 6비트를 품질 비교용으로 먼저 두고, 4비트에 DFlash2를 붙인 결과가 실제 작업에서 충분히 괜찮은지 보는 쪽이다. 답이 사실상 같다면 빠른 쪽을 쓰면 된다. 반대로 반복 호출이나 지시 누락이 줄어든다면 조금 느려도 덜 깎은 쪽을 남길 이유가 생긴다. 파일 크기는 변환한 저장소마다 다르니 “27B 6비트는 몇 GB” 하고 한 숫자로 외우지는 말자.

특히 ddalcu의 6비트 모델 카드는 용량 설명 일부가 서로 맞지 않는 부분이 있어서 이 글에서는 확정 용량표에 넣지 않았다. 다운로드할 저장소의 실제 파일 합계를 확인하는 편이 낫다. 인터넷을 뒤지다 보면 숫자보다 숫자 옆의 작은 글씨가 더 중요한 경우가 많다.

3. 빠른 일꾼은 Qwen3.6-35B-A3B

이름만 보면 35B니까 27B보다 더 무거울 것 같지만, 이건 MoE다. 전체는 35B이고 토큰마다 약 3B를 활성화한다. 모델을 메모리에 올리는 용량은 전체 기준으로 필요하지만, 매번 계산하는 양은 그보다 훨씬 작다. 그래서 반복적인 코드 수정, 요약, 분류, 정보 추출 같은 일을 많이 시키려면 꽤 매력적인 선택지가 된다.

아래 엔진 비교에서도 이 모델은 확실히 빠르다. 다만 속도가 빠르다고 어려운 문제까지 더 잘 푼다는 뜻은 아니다. 주력 답변의 품질은 27B로 확인하고, 자주 반복하는 일을 35B-A3B에 맡기는 식으로 역할을 나눠볼 만하다. 메모리가 넉넉하다고 둘을 꼭 동시에 띄워놔야 하는 것도 아니다. 필요할 때 갈아 끼우면 된다.

4. 한국어 글쓰기와 큰 모델 욕심은 별도 트랙으로

한국어 문서나 글쓰기는 Gemma 4 31B도 비교 후보로 두고 싶다. 31B dense 모델이고 이미지 입력, 추론 모드, 함수 호출을 지원한다. 참고로 Gemma 4는 Apache 2.0이다. 예전 Gemma 라이선스만 기억하고 있으면 헷갈릴 수 있는 부분.

그렇다고 “한국어는 Gemma가 무조건 최고”라고 적을 근거는 못 찾았다. 같은 한국어 문제를 같은 조건으로 제대로 비교한 자료가 부족하다. 요약에서 뭘 빼먹는지, 번역투가 얼마나 남는지, 내가 원하는 문체가 나오는지는 직접 같은 글을 던져보고 고르는게 맞다. 영어 벤치마크 숫자가 내 블로그 말투까지 대신 골라주지는 않는다.

그리고 큰 모델을 올려보고 싶은 마음을 자극하는 쪽에는 Qwen3.8-Flash-Next가 있다. 공식 설명은 본체 125B에 n-gram embedding 51B, MTP 4B를 더한 구조다. 어디서는 125B라고 하고 어디서는 180B라고 하는 이유가 여기에 있다. 이걸 64GB에서? 싶지만 저비트 양자화와 SSD 스트리밍을 같이 쓰면 가능해졌다.

GSQ-RCO Q2_0 기준으로 본체 shard는 37.6GB, n-gram shard는 28.8GB다. 합치면 66.4GB인데 n-gram 테이블을 SSD에 두고 필요한 부분만 읽는 식이다. 여기에 draft, KV cache, 작업 공간은 별도로 생각해야 한다. 이건 모든 데이터가 RAM에 올라간 4비트 27B와는 운영 조건부터 다르다.

Splash 1.4.0 개발자 측정에서는 M5 Pro 20코어 GPU, 64GB에서 Flash-Next Q2_0으로 95 tok/s가 나왔다. 솔깃하다. 다만 선택된 코드 프롬프트에 DFlash2를 사용한 결과이고, Q2 양자화의 품질도 따로 봐야 한다. 양자화 제작자 평가에서 LiveCodeBench는 BF16의 87.43에서 Q2의 81.14로 내려갔다. 이것만으로 한국어나 긴 에이전트 작업의 품질까지 설명할 수는 없다.

게다가 10월 21~22일에는 같은 M5 Pro 64GB에서 Splash 1.4.0의 도구 호출이 반복된다는 사용자 보고도 올라왔다. 원인이나 모든 환경의 문제로 확정할 수는 없지만, 지금 당장 주력으로 밀어붙이기보다는 실험용으로 남겨두고 싶다. Flash-Next는 Qwen Community License 1.0이라 상업 서비스에 쓸 때는 조건도 별도로 확인해야 한다. 큰 모델이라고 고민까지 작아지는 건 아니다.

5. 진짜 변수는 실행 엔진이었다

이번에 정리하면서 가장 크게 생각이 바뀐 부분이다. 한때는 “맥이면 MLX”, 조금 지나서는 “Qwen이면 Splash” 같은 한 줄 결론으로 정리하고 싶었는데, 최신 자료까지 보면 그렇게 단순하지 않았다. 이미 쓰는 mlx-serve도 DFlash2를 제대로 붙이면 꽤 빠르고, Kapitsa라는 새 엔진도 공격적으로 속도를 끌어올리고 있다.

아래는 Kapitsa 프로젝트가 공개한 비교 자료에서 가져온 생성 속도다. MacBook Pro M5 Pro, 20코어 GPU, 48GB에서 코드 응답을 temperature 0.6으로 생성한 값이다. 내 맥미니 64GB 실측이 아니고, 일부 셀은 측정 날짜와 빌드가 다르며 다른 앱의 GPU 사용이 감지된 실행도 포함된다. 엔진 개발자 측 자료라는 점까지 감안하고 봐야 한다.

4비트 모델mlx-serve 26.10.2Splash 1.4.0Kapitsa 개발 빌드
Qwen3.8-27B약 78 tok/s약 72 tok/s약 81 tok/s
Qwen3.6-35B-A3B약 156 tok/s약 181 tok/s약 201 tok/s

27B에서 mlx-serve는 DFlash2, Splash도 DFlash2, Kapitsa는 KFlash를 사용한 결과다. 35B-A3B에서 mlx-serve는 MTP다. 동일 모델이라고 모든 세팅까지 동일한 비교는 아니라는 얘기. 특히 27B의 mlx-serve와 Kapitsa 차이는 자료 작성자도 측정 편차 안의 사실상 동률로 본다. 저 숫자만 보고 3 tok/s 더 빠르다고 이사 갈 일은 아니다.

반대로 같은 비교 세션에서 Splash는 두 모델 모두 프롬프트를 읽는 속도가 더 빨랐다. 새로 긴 문서를 자주 넣는 작업이라면 토큰 생성 순위와 전체 작업 시간 순위가 달라질 수 있다. 생성 속도는 GPU가 말을 하기 시작한 뒤의 속도고, 그 전에 문서를 읽고 생각하느라 기다리는 시간은 따로다.

실제 맥미니 M5 Pro 64GB 사용자 보고도 같이 보자. Splash에서 Qwen3.8-27B UD-Q4_K_XL로 약 50 tok/s, Q8_0으로 4K 입력에서 약 35.3 tok/s를 기록한 사례가 있다. 서로 프롬프트와 양자화가 다르니 위 표와 한 줄로 순위를 매길 수는 없다. 다만 “최대 74”나 “최대 81”이 내가 아무 질문이나 던졌을 때의 보장 속도가 아니라는 건 분명하다.

그래서 지금 판단은 이렇다. 이미 mlx-serve를 쓰면 업데이트와 DFlash2 설정부터. 긴 새 입력이 많으면 Splash 비교. 생성 속도 한계까지 보고 싶으면 Kapitsa를 추가로 시험. LM Studio나 oMLX가 편하면 그것도 괜찮지만 앱 이름만 보지 말고 실제 backend가 뭔지 확인할 것. 같은 간판 아래에서도 엔진이 다르면 결과가 달라진다.

6. 성능 튜닝은 이 순서로

첫째, speculative decoding이 실제로 켜져 있는지 확인. 작은 모델이 다음 토큰들을 미리 제안하고 본 모델이 검증하는 방식이다. MTP와 DFlash2는 구현이 다르고 잘 맞는 작업도 다르다. 코드의 들여쓰기나 반복되는 식별자처럼 예측하기 쉬운 출력에서는 이득이 크지만, 새로운 설명문을 쓰는 상황에서는 줄어들 수 있다. draft 길이는 길수록 좋은게 아니다.

둘째, 컨텍스트는 32K부터. 일반 대화와 짧은 코드는 32K, 문서나 저장소 분석은 64K로 시작하고 정말 필요할 때 더 늘리는 편이 낫겠다. 에이전트의 시스템 프롬프트와 도구 정의만으로 수만 토큰을 쓰는 경우도 있으니 무조건 32K면 된다는 뜻은 아니다. 모델이 256K를 지원한다고 설정부터 끝까지 올릴 이유는 없다는 이야기다.

셋째, prefix cache는 살려둘 것. 공개된 Mac mini M5 Pro llama.cpp 측정에서 32K 문맥에 512개 새 토큰을 더한 입력은 캐시 없이 첫 토큰까지 약 110초, 문맥 캐시가 맞으면 약 2.4초였다. 에이전트는 같은 시스템 프롬프트와 대화를 계속 다시 보내니 이런 차이가 크게 쌓인다. 캐시가 맞은 숫자를 “프롬프트 읽기 성능”이라고 자랑하는 것도 조심해야 한다. 안 읽었으니 빠른 것일 수 있다.

넷째, KV cache 양자화는 엔진별로 접근. 웨이트를 4비트로 줄이는 것과 KV cache를 4비트로 줄이는 건 다른 설정이다. mlx-serve는 메모리가 충분하면 KV 양자화 off부터 비교하고, 메모리가 부족해질 때 8비트를 검토하는 쪽이 출발점이다. 반면 Splash는 기본이 INT8 KV다. 한 엔진의 최적 세팅을 다른 엔진에 그대로 복사하는 건 별로 좋은 방법이 아니다.

다섯째, 혼자 쓰면 동시 요청은 1개부터. 여러 요청을 묶으면 전체 처리량은 늘어도 내 질문 하나가 끝나는 시간은 길어질 수 있다. 여러 에이전트를 굴릴 때만 2개, 4개로 늘려보고, 일반 채팅에서는 일단 단순하게 시작하자.

여섯째, thinking 양과 메모리 압박 확인. 단순 요약은 thinking을 끄거나 낮춰보고, 어려운 코드 수정은 충분히 생각하게 하는 쪽이 낫다. 낮추면 매 턴은 짧아져도 틀려서 재시도하면 전체는 더 오래 걸린다. 활동 모니터에서 메모리 압박과 작업 중 스왑 증가도 보자. 큰 모델을 서버마다 중복으로 올려놓고 “왜 느리지?” 하고 있으면 모델은 좀 억울할 수 있다.

저전력 모드는 끄고, 고성능 모드가 제공되는 환경이면 자동 모드와 비교할 만하다. 다만 특정 구형 엔진에서 크게 빨라졌다는 한 번의 측정을 모든 모델에 일반화하지는 말자. GPU 메모리 한도부터 무작정 올리는 sysctl 튜닝도 뒤로 미루겠다. 일단 정상적으로 메모리에 들어가는 모델부터 잘 굴리는게 순서다.

7. 일단 이렇게 시작해볼 생각

mlx-serve에서는 우선 아래처럼 4비트 모델에 기본 MTP를 쓰는 구성을 기준점으로 삼을 수 있다. 앱에서 이미 서버가 떠 있다면 CLI까지 중복으로 띄우지 말고 하나만 사용하자. 아래는 추천 시작 설정이지, 내 맥에서 완료 검증한 설치 절차는 아니다.

mlx-serve \
  --model ddalcu/Qwen3.8-27B-MLX-Serve-4bit \
  --serve \
  --host 127.0.0.1 \
  --ctx-size 32768 \
  --max-concurrent 1 \
  --kv-quant off \
  --prefix-cache-disk 16GB

위 명령은 기본 MTP다. 앞의 비교표에서 나온 DFlash2 속도를 내려면 호환되는 Qwen3.8-27B-DFlash2 draft를 따로 로컬에 받고, 실제 디렉터리를 –drafter로 지정해야 한다. 공개 벤치마크 구성은 그때 –no-mtp도 함께 사용했다. 시작 로그에서 DFlash나 drafter ready 같은 표시를 확인할 것. 모델에 MTP가 들어 있다고 자동으로 DFlash2가 되는 건 아니다.

Splash는 대응되는 draft를 자동으로 받는 쪽이라 비교 시작은 더 간단하다. M3 이상, macOS 26.4 이상이 필요하다. 처음 설치하는 경우는 다음과 같다. 이미 설치했다면 install 대신 업그레이드하고 기존 서버를 먼저 종료하면 된다.

brew install incoai/tap/splash

splash serve \
  --model unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --max-context 32K \
  --idle-release off \
  --persistent-cache \
  --max-cache-disk 16G

이미지나 PDF 입력이 전혀 필요 없을 때만 –language-only를 추가하면 된다. –idle-release off는 유휴 상태에도 모델을 남겨두는 옵션이고, –persistent-cache는 재시작 뒤에도 SSD의 대화 캐시를 재사용하기 위한 옵션이다. 여기의 16G는 모델 저장 공간을 지정한게 아니라 캐시 한도다.

M4 Pro 24GB까지 같이 쓴다면 메모리를 억지로 합칠 생각부터 하기보다는 작은 모델, 임베딩, 리랭킹, 음성 인식 같은 일을 나누는 쪽부터 보겠다. mlx-serve의 LAN Sharing은 다른 맥의 모델로 요청을 전달하는 기능이다. 64+24를 체크박스 하나로 88GB짜리 맥으로 만들어주는 기능은 아니다. 별도의 분산 추론 기능과는 구분해야 한다.

그래서 결론은

64GB가 생기면 가장 큰 모델부터 받아보고 싶은게 사람 마음이다. 하지만 이번에 자료를 모아보니 실용적인 출발점은 생각보다 소박했다. Qwen3.8-27B를 주력으로 놓고, 양자화와 draft, cache가 제대로 맞물리게 만드는 것. 속도가 더 필요한 일은 Qwen3.6-35B-A3B로 보내고, Flash-Next는 일단 별도의 실험 과제로 남겨두는 쪽이다.

최종 선택은 같은 한국어 요약, 코드 수정, 긴 문서 질문을 열 개쯤 준비해서 돌려보면 될 것 같다. 첫 응답까지 걸린 시간, 최종 답까지 걸린 시간, 정답률, 도구를 쓸데없이 반복하는지. 이 네 가지를 보면 tok/s 하나만 볼 때보다 훨씬 빨리 답이 나올 것이다.

메모리 고민을 끝내려고 메모리를 늘렸더니 이번엔 엔진이랑 draft를 고르고 있다. 결국 로컬 LLM은 “내 컴퓨터에서 AI를 쓴다”는 취미인 동시에 “AI를 쓰기 좋은 컴퓨터 상태를 계속 만든다”는 취미인 모양이다. 뭐… 그 과정이 재밌으니까 계속 이러고 있겠지만.

참고한 자료

날짜가 있는 수치는 위에 적은 기준일의 공개 자료다. 엔진 업데이트가 워낙 빠르니 설치할 때는 버전과 알려진 문제를 다시 확인하는게 좋겠다. 서로 다른 벤치마크의 품질 점수는 평가 도구와 문제 구성이 다를 수 있어 한 표로 순위를 매기지 않았다.

Apple: Mac mini M5 Pro 사양

Apple: M5 GPU Neural Accelerator와 MLX

Qwen3.8-27B 공식 모델 카드

Qwen3.6-35B-A3B 공식 모델 카드

Gemma 4 31B 공식 모델 카드

Flash-Next 공식 모델 카드와 라이선스

Flash-Next GSQ-RCO 양자화: 크기와 품질 평가

Mac mini M5 Pro 64GB llama.cpp 실측
Kapitsa: M5 Pro 엔진별 벤치마크와 측정 조건

mlx-serve 성능 설정

mlx-serve CLI 옵션

Splash 성능 측정

Splash 1.4.0 릴리스

Splash 도구 호출 반복 사용자 보고 #538

M5 Pro 64GB Q4급 사용자 보고 모음

M5 Pro 64GB Q8_0 사용자 보고 모음

AMD Gorgon Halo vs Strix Halo: 뭐가 달라졌고, 어떤 모델을 얼마나 빠르게 돌릴 수 있나

또 AMD가 한 세대를 넘겼다. 아니, 넘겼다고 하기엔 좀 애매한데… 암튼 작년 로컬 LLM 동네를 들썩이게 했던 Strix Halo(Ryzen AI Max 300 시리즈) 후속으로 5월에 Gorgon Halo(Ryzen AI Max PRO 400 시리즈)라는게 발표됐고, 이번 IFA 2026을 기점으로 실제 제품들이 슬슬 얼굴을 내밀기 시작했다. 맥미니에 로컬 LLM 올려놓고 깨작거리다 보면 “메모리만 좀 더 있었으면…”하는 순간이 꼭 오는데, 그 가려운 데를 긁어주겠다고 나온 물건이라 그냥 지나칠 수가 없었다. (네, 그 병이 또 도졌다.)

그래서 정리해봤다. 두 칩이 실제로 뭐가 다른지, 각각 어디까지 큰 모델을 올릴 수 있고 그때 토큰이 얼마나 나오는지, 그리고 지금 “진짜로” 출시 확정된 제품은 뭐가 있는지.

한 줄 요약부터

Gorgon Halo는 Strix Halo에 메모리만 192GB로 늘려준 리프레시다. 아키텍처(Zen 5 + RDNA 3.5 + XDNA 2)는 그대로고, 속도도 거의 그대로. 대신 “더 큰 모델을” 혹은 “같은 모델을 덜 깎아서” 올릴 수 있게 됐다. 이게 전부다. 진짜로.

1. 스펙 비교: 뭐가 달라졌나

양쪽 플래그십인 Ryzen AI Max+ 395랑 Ryzen AI Max+ PRO 495를 놓고 보면 이렇다.

항목Strix Halo (Ryzen AI Max+ 395)Gorgon Halo (Ryzen AI Max+ PRO 495)
CPUZen 5, 16코어 / 32스레드Zen 5, 16코어 / 32스레드 (동일)
CPU 부스트 / 베이스5.1 GHz / 3.0 GHz5.2 GHz / 3.1 GHz (+100MHz)
GPURadeon 8060S, RDNA 3.5, 40CU, 2.9GHzRadeon 8065S, RDNA 3.5, 40CU, 3.0GHz
NPU (XDNA 2)50 TOPS55 TOPS
총 AI 연산126 TOPS131 TOPS
최대 통합 메모리128GB LPDDR5X-8000192GB LPDDR5X-8533
최대 VRAM 할당96GB160GB
메모리 대역폭256 GB/s273 GB/s (+6.6%)
캐시80MB80MB (동일)
cTDP45-120W45-120W (동일)

보다시피 CPU/GPU 클럭 각각 100MHz씩 올라간게 전부고, 공정도 코어 수도 CU 수도 캐시도 TDP도 다 그대로다. 유출된 PassMark 기준으로 멀티 10%, 싱글 5% 정도 오른 모양인데, 이건 전압-주파수 커브 살짝 손본 정도로 보인다. 해외 리뷰어 중엔 대놓고 “이름만 바꾼 리배지”라고 하는 사람도 있더라. 뭐… 틀린 말은 아니다.

진짜 바뀐 건 메모리 컨트롤러다. SoC 다이의 메모리 컨트롤러를 손봐서 192GB LPDDR5X-8533까지 붙일 수 있게 됐고, 그중 160GB를 GPU 쪽으로 몰아줄 수 있다. AMD 공식 멘트로는 “4bit 양자화 기준 300B 이상 파라미터를 로컬에서 돌리는 최초의 x86 클라이언트 프로세서”란다. 마케팅 멘트치고는 꽤 구체적이라 오히려 신뢰가 간다.

근데 아쉬운 점도 분명하다. 메모리 버스가 여전히 256비트라 대역폭은 256GB/s에서 273GB/s로 6.6%밖에 안 늘었다. 딱 DGX Spark 수준. 메모리는 커졌는데 대역폭이 그대로라는 건, 큰 모델을 올릴 수는 있어도 토큰 뽑는 속도는 안 빨라진다는 얘기다. 이게 왜 중요한지는 바로 다음에.

참고로 라인업은 PRO 495(16코어/40CU), PRO 490(12코어/32CU), PRO 485(8코어/32CU) 세 종류인데, 하위 모델도 전부 192GB 지원이다. 비(非)PRO 버전은 늘 그렇듯 “coming soon”.

2. 토큰 속도는 “모델 크기”가 정하는게 아니다

이 동네 칩들의 LLM 성능을 이해하려면 딱 하나만 기억하면 된다. Halo 계열은 메모리 대역폭 병목이다. iGPU가 아무리 좋아도, NPU가 55 TOPS건 뭐건, 토큰 생성 속도는 결국 “토큰 하나 만들 때 메모리에서 읽어야 하는 양”을 대역폭으로 나눈 값으로 수렴한다.

그래서 총 파라미터 수보다 활성 파라미터 x 양자화 비트가 훨씬 중요하다. 235B짜리 MoE라도 토큰당 활성이 22B면 22B만큼만 읽으면 되고, 70B dense는 매 토큰마다 70B를 통째로 읽어야 한다. 그래서 Halo 계열에서는 MoE가 비슷한 크기 dense보다 3배에서 14배까지 빠르다.

감을 잡기 위한 기준 하나. 50 tok/s면 거의 즉답 느낌이고, 15-20 tok/s면 채팅용으로 무난하고, 5 tok/s 아래는 reasoning 모델에서는 생각하는거 기다리다 딴짓하게 되는 수준이다.

3. Strix Halo (128GB): 실측 데이터

Strix Halo는 이미 1년 넘게 전세계 홈랩러들이 굴려온 플랫폼이라 실측치가 넘쳐난다. 실제로 쓸 수 있는 VRAM은 OS 예약분 빼고 96-120GB 정도. 이 안에 70B Q4 dense 전부랑 120B급 MoE 대부분이 들어간다. 아래는 llama.cpp 기준 커뮤니티 실측치들을 모아본 것.

모델구조양자화 / 용량생성 속도 (실측)
gpt-oss-120bMoE (5B 활성)MXFP4, 59GB45-55 tok/s
Qwen3.5 122B-A10BMoE (10B 활성)MXFP4, 70GB약 19 tok/s
Llama 4 Scout 109BMoE (17B 활성)Q4, 61GB약 19 tok/s
Nemotron 3 Super 120B-A12BMoE (12B 활성)IQ4, 약 60GB약 18 tok/s
Qwen3-235B-A22BMoE (22B 활성)Q3_K_M, 105GB약 8 tok/s
Llama 3.3 70BDenseQ4, 42GB약 5 tok/s
Llama 3.3 70BDenseQ6, 54GB약 4 tok/s

Strix Halo의 상한선은 단일 기기에서 235B MoE를 Q3로 겨우 밀어넣는 정도다(105GB, 8 tok/s). MiniMax M2 230B급이나 284B급 GGUF를 올린 사례도 있긴 한데… “올라간다”랑 “쓸만하다”는 엄연히 다른 얘기다. 실용적인 sweet spot은 120B급 MoE(약 50 tok/s)고, 70B dense는 5 tok/s로 좀 답답하다.

4. Gorgon Halo (192GB): 추정치

Gorgon Halo는 아직 시장에 풀린 물건이 없어서 독립적인 실측치가 없다. 다만 대역폭이 6.6% 늘었으니 같은 모델이면 Strix Halo보다 5-7% 빠른 정도로 보면 될 것 같다. 아래 표는 Strix Halo 실측치를 대역폭 비율로 환산해서 뽑아본 추정치라 그 정도 감안하고 봐주시길.

모델구조양자화 / 용량예상 속도 (추정)
Qwen3-235B-A22BMoE (22B 활성)Q4_K_M, 약 135GB8-10 tok/s (Q3 대신 Q4로 품질 확보)
Qwen3.5-397B-A17BMoE (17B 활성)Q2-Q3, 140-160GB12-18 tok/s
GLM-4.5 355B-A32BMoE (32B 활성)Q3, 약 150GB5-7 tok/s
DeepSeek V3/R1 671BMoE (37B 활성)1.5-2bit, 약 160GB3-5 tok/s (품질 손실 큼, 비추천)
120B급 MoEMoEQ8 (고품질), 약 120GB25-30 tok/s
70B denseDenseQ8, 75GB약 3 tok/s

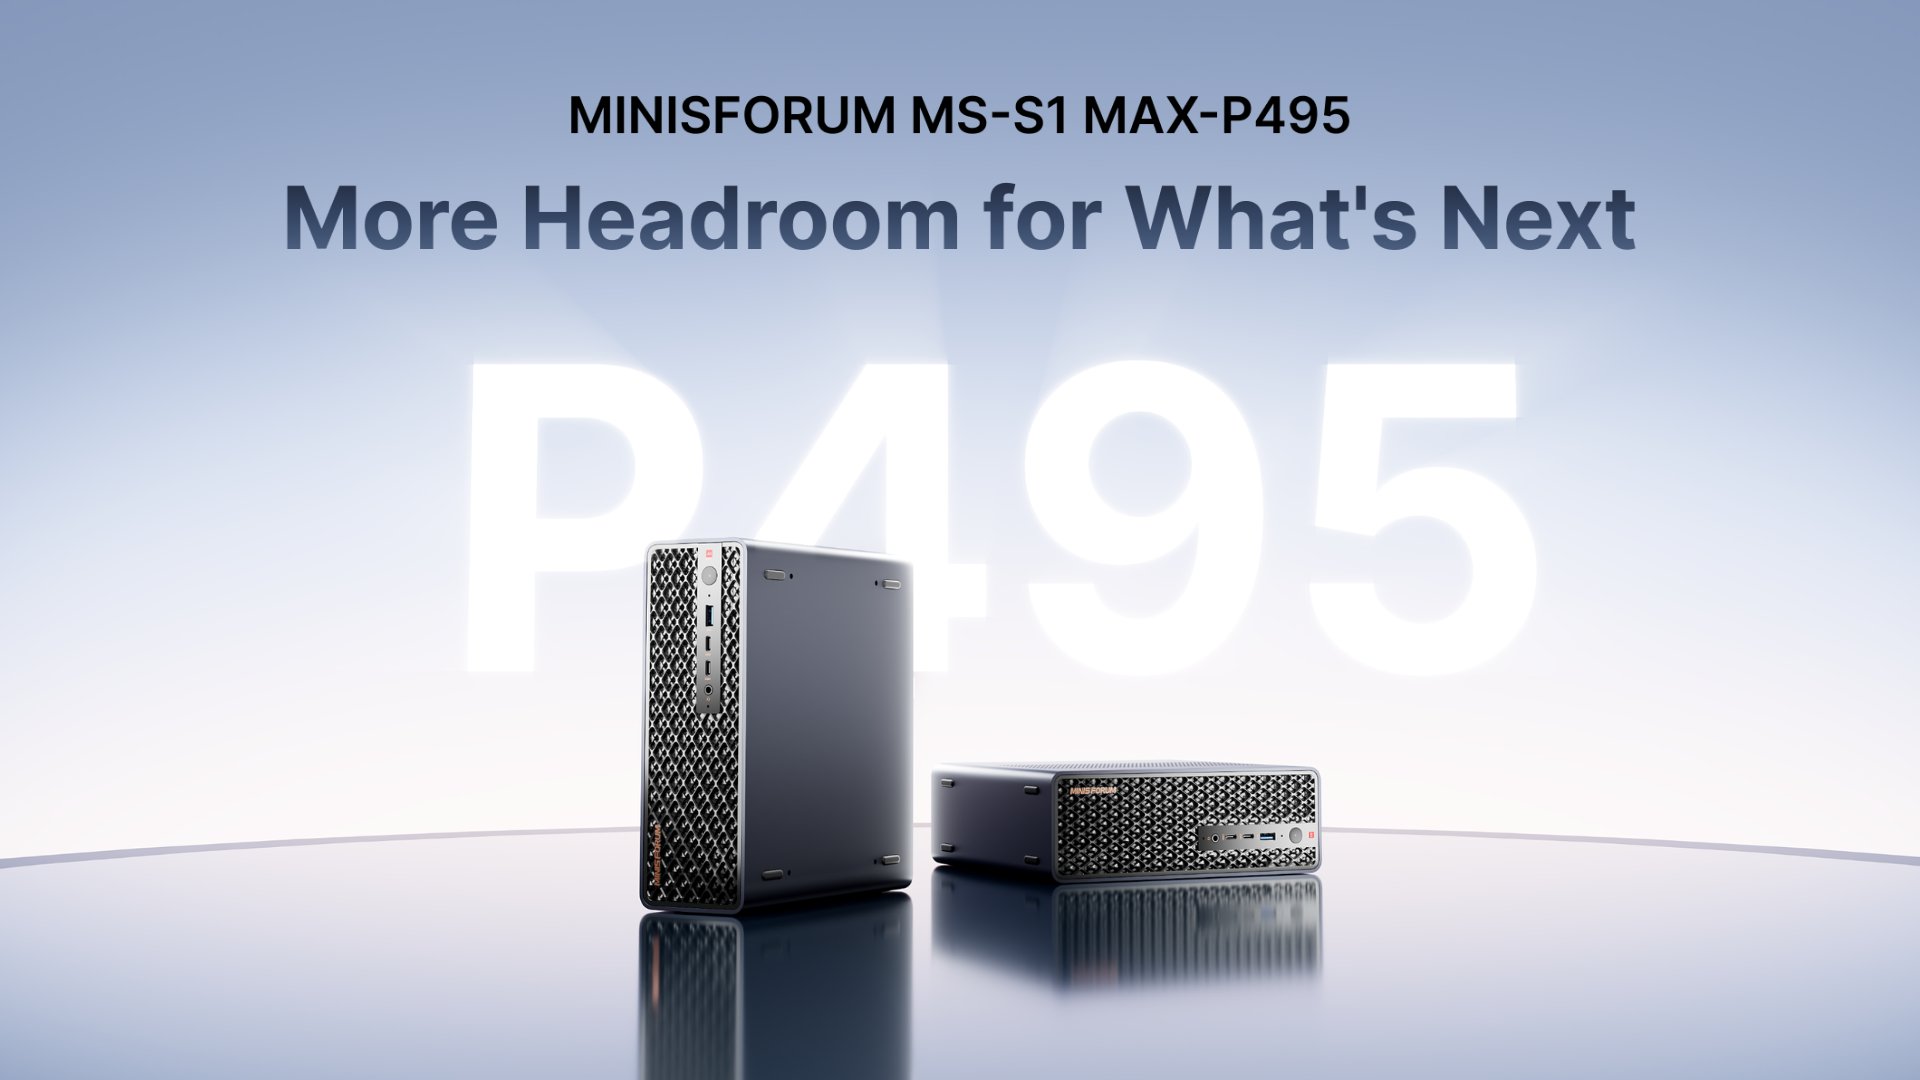
참고할 만한 공식 수치가 하나 있는데, Minisforum이 MS-S1 MAX-P495 2대를 클러스터로 묶어서 Qwen3.5-397B를 16 tok/s로 돌렸다고 한다. 한 대라면 이보다 양자화를 더 깎아서 10-15 tok/s 정도가 현실적인 추정.

그러니까 Gorgon Halo의 가치는 “더 빠르게”가 아니라 “더 크게, 혹은 더 정확하게”다. 235B MoE를 Q3 대신 Q4로 올리거나, 400B급 MoE를 저비트로 억지로라도 올리거나, 120B급 MoE를 Q8로 여유 있게 돌리거나. 이게 192GB가 열어주는 선택지다. 반대로 지금 128GB로 충분히 만족하고 있다면 갈아탈 이유는… 솔직히 거의 없다.

신제품이 발표된 이 시점에 뭘 골라야 하는가에 대해서는 사실 나도 고민이라… Mac Studio 128GB이 눈 앞에 아른거리지만… 그렇지만…

5. 그래서 지금 살 수 있는 건?

9월 초 IFA 2026을 기점으로 제품 발표가 줄줄이 이어지는 중이다. 출시 시점을 확실히 밝힌 것과 아직 티저 단계인 것을 나눠보면 이렇다.

출시 시점을 공식으로 밝힌 제품

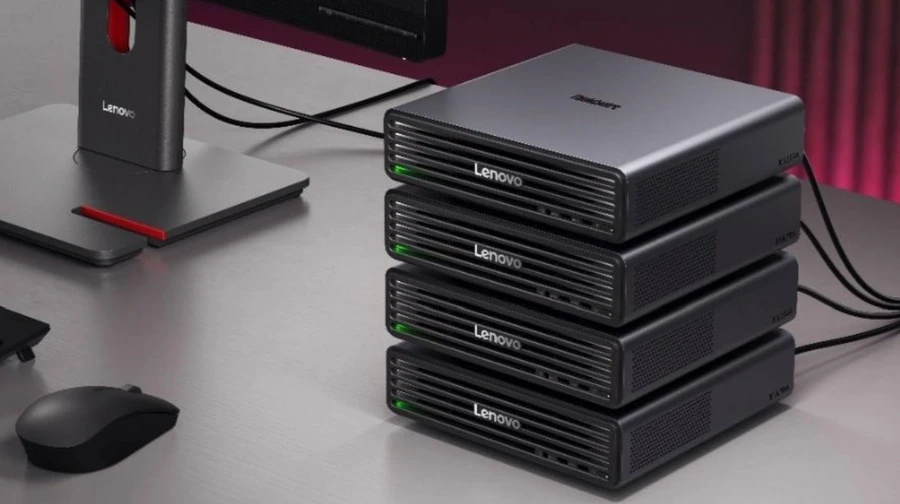
  • Lenovo ThinkCentre X Ultra (1.6L, 최대 128GB): 가장 구체적이다. 2026년 11월 출시, 미국 시작가 $3,699. Windows 11이나 Linux 중 고를 수 있고, 10GbE에 Thunderbolt 4 두 개. 레노보는 이걸 4대 쌓아서 클러스터로 쓰라고 대놓고 밀고 있다.
Lenovo ThinkCentre X Ultra
Lenovo ThinkCentre X Ultra. 1.6L 크기에 Ryzen AI Max+ PRO 495와 최대 128GB 메모리를 담았다. 나도 저렇게 4대 쌓아놓고 써봤으면 좋겠다… (출처: Lenovo)
  • MINISFORUM MS-S1 MAX-P495 (192GB): IFA 2026에서 공식 발표, 9월 중 판매 시작 예정. 160GB VRAM 할당에 2U 랙 마운트 지원. 가격은 아직 안 나왔는데 EU 스토어에 “€7???” 라고 티저를 띄워놔서 대충 7,000-8,000달러대로 추정된다. 같은 칩 박은 5베이 NAS인 N5 MAX-P495도 같이 나왔다.
MINISFORUM MS-S1 MAX-P495
MINISFORUM MS-S1 MAX-P495. 192GB 통합 메모리, 160GB VRAM 할당, 2U 랙 마운트 지원. 여긴 변태 스펙의 NAS 출시를 즐기는 모양이다. 폼팩터는 MS-S1이 워낙 잘 뽑혀서 계속 가는 듯.(출처: MINISFORUM)

발표는 했는데 판매일은 아직인 제품

  • GMKtec EVO-X5 Pro: IFA 2026(9월 5일) 공개. 판매일이랑 가격은 미정. 192GB 최상위는 4,000달러대라는 얘기가 돌고 있다. USB4 4포트에 10GbE 포함 이더넷 2포트, USB4로 외장 GPU 연결 및 최대 4대 클러스터 구성이 가능하다. 부스에서 Qwen3.8-Flash-Next 라이브 데모를 공개했다(바로 아래).
  • Framework Desktop 192GB: 공식 페이지에 “coming soon” 탭만 덜렁.
  • ACEMAGIC F9A (192GB): 공개는 됐는데 출시일은 미확인.
  • AMD Ryzen AI Halo 개발 플랫폼 (Gorgon 버전): AMD가 “3분기 중” OEM 시스템이랑 같이 나온다고만 한 상태.

참고: EVO-X5 Pro 부스 데모에서 첫 공개 수치가 나왔다

위 목록에서 ‘실제로 돌아가는 모습’이 공개된 건 EVO-X5 Pro가 유일하다. IFA 2026 GMKtec 부스 라이브 데모에서 EVO-X5 Pro가 Qwen3.8-Flash-Next를 구동했는데, Notebookcheck 현장 기사에 따르면 토큰 생성 속도가 초당 두 자릿수로 안정적으로 나와 거의 실시간 대화가 가능한 수준이었다고 한다.

데모 화면을 찍은 사진을 뜯어보면 수치가 더 구체적으로 나온다. LM Studio 로컬 서버(127.0.0.1:8080)에 Qwen3.8-Flash-Next-UD-Q4_K_XL(Unsloth Dynamic 4비트 양자화)이 올라가 있었고, 마지막 응답 기준 3.7초에 67토큰, 즉 17.9 tok/s였다. 이 글에서 기준으로 삼은 속도 구간으로 치면 “채팅용으로 무난한” 15-20 tok/s 구간이다.

물론 공식 벤치마크가 아니라 부스 데모 화면 사진에서 읽어낸 수치라 컨텍스트 길이나 프롬프트 처리 속도 같은 조건은 알 수 없다. 그래도 192GB에 4비트 모델이 통째로 올라가서 두 자릿수 토큰이 나오는 걸 눈으로 본 첫 사례라는 점에서, 4번 섹션의 추정표가 크게 틀리지 않았다는 방증 정도로 기록해둔다. 출처는 Notebookcheck의 IFA 2026 현장 기사.

6. 그럼 DGX Spark는?

이 가격대에서 Halo 계열의 직접적인 맞수는 아무래도 NVIDIA DGX Spark다. GB10 Grace Blackwell에 128GB LPDDR5X를 얹은 박스인데, 대역폭이 273GB/s라 Gorgon Halo랑 똑같고 Strix Halo보단 7% 정도 높다. 그래서 토큰 생성 속도는 셋 다 거기서 거기다. gpt-oss-120b 기준으로 DGX Spark 52-56 tok/s, Strix Halo 45-55 tok/s니까 오차 범위 안. 차이가 벌어지는 건 프롬프트 처리(prefill) 쪽인데, 이건 대역폭이 아니라 연산 성능 싸움이라 Blackwell 텐서코어 + CUDA 조합이 훨씬 세다. 2-5배 정도. 긴 문서 던져넣거나 컨텍스트 빵빵한 에이전트 돌릴 때 첫 토큰 나올 때까지의 기다림이 체감상 꽤 다르다. 이미지 생성 같은 순수 연산 작업도 2.5배 정도 DGX Spark가 앞선다.

항목NVIDIA DGX SparkStrix Halo (128GB)Gorgon Halo (192GB)
통합 메모리128GB128GB192GB
대역폭273 GB/s256 GB/s273 GB/s
AI 연산 (공식)~1 PFLOP FP4126 TOPS131 TOPS
OSLinux 전용 (DGX OS)Windows / LinuxWindows / Linux
소프트웨어 스택CUDA, TensorRT-LLM, vLLMROCm / Vulkan, llama.cppROCm / Vulkan, llama.cpp
토큰 생성 (120B MoE)52-56 tok/s45-55 tok/s50-60 tok/s (추정)
프롬프트 처리매우 빠름 (기준)2-5배 느림2-5배 느림 (추정)
가격$3,999-4,699$2,000-4,000$3,699 (128GB) / 7,000달러대 (192GB)

그러면 Gorgon Halo 192GB가 DGX Spark 대비 갖는 의미는 명확하다. DGX Spark는 한 대로는 200B 언저리가 한계고 그 이상은 두 대를 ConnectX-7로 묶어야 하는데, Gorgon Halo는 한 대로 300B급 4bit를 올린다. 반대로 CUDA 생태계, 파인튜닝, 빠른 프롬프트 처리가 필요하면 여전히 DGX Spark가 편하다. 정리하면 “제일 큰 모델 한 대에 올려놓고 채팅/추론 위주로 쓰겠다”면 Gorgon Halo, “CUDA로 개발하고 긴 컨텍스트 자주 넣겠다”면 DGX Spark. 다만 192GB Gorgon Halo가 7,000달러대로 예상되는 만큼 DGX Spark 두 대(256GB) 값이랑 겹치는 구간이라… 가성비 판단은 실제 출시가 나온 뒤에 다시 해봐야 할 것 같다.

그래서 결론은

  • Gorgon Halo는 Strix Halo에 메모리만 192GB로 늘린 리프레시. 클럭 +100MHz, NPU +5 TOPS, 대역폭 +6.6%. 끝.
  • Strix Halo(128GB) 실용 한계는 120B급 MoE(약 50 tok/s) 아니면 235B MoE Q3(약 8 tok/s). 70B dense는 5 tok/s.
  • Gorgon Halo(192GB)는 235B MoE를 Q4로 8-10 tok/s, 400B급 MoE를 저비트로 10-15 tok/s 정도로 추정. 속도가 아니라 용량이랑 양자화 품질에서 이득.
  • 어느 쪽이든 MoE 위주로 골라야 한다. 대형 dense는 둘 다 실용성 없음.
  • DGX Spark랑 비교하면 토큰 생성은 거의 같고, 프롬프트 처리랑 CUDA 생태계는 DGX Spark가, 한 대에 올릴 수 있는 최대 모델 크기는 Gorgon Halo가 앞선다.
  • 지금 날짜랑 가격까지 다 나온 건 Lenovo ThinkCentre X Ultra(11월, $3,699)가 유일하고, Minisforum MS-S1 MAX-P495는 9월 내 판매 예정.

Gorgon Halo 쪽 속도 수치는 제품이 아직 안 나와서 실측이 없고, Strix Halo 실측치에 대역폭 비율 곱해서 뽑은 추정치라는 점은 다시 한 번. 실제 리뷰들이 하나 둘 나오는 시점에 다시 한 번 업데이트 해보겠다… 뭐… 내가 직접 하면 더 좋을지도 모르겠지만…

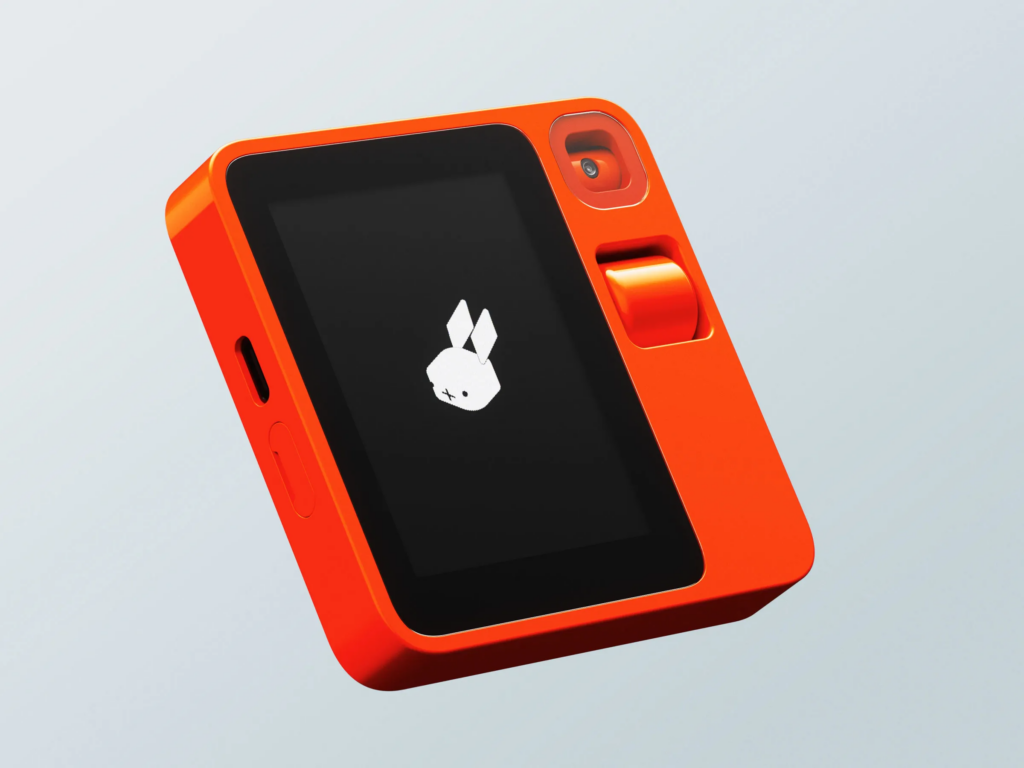
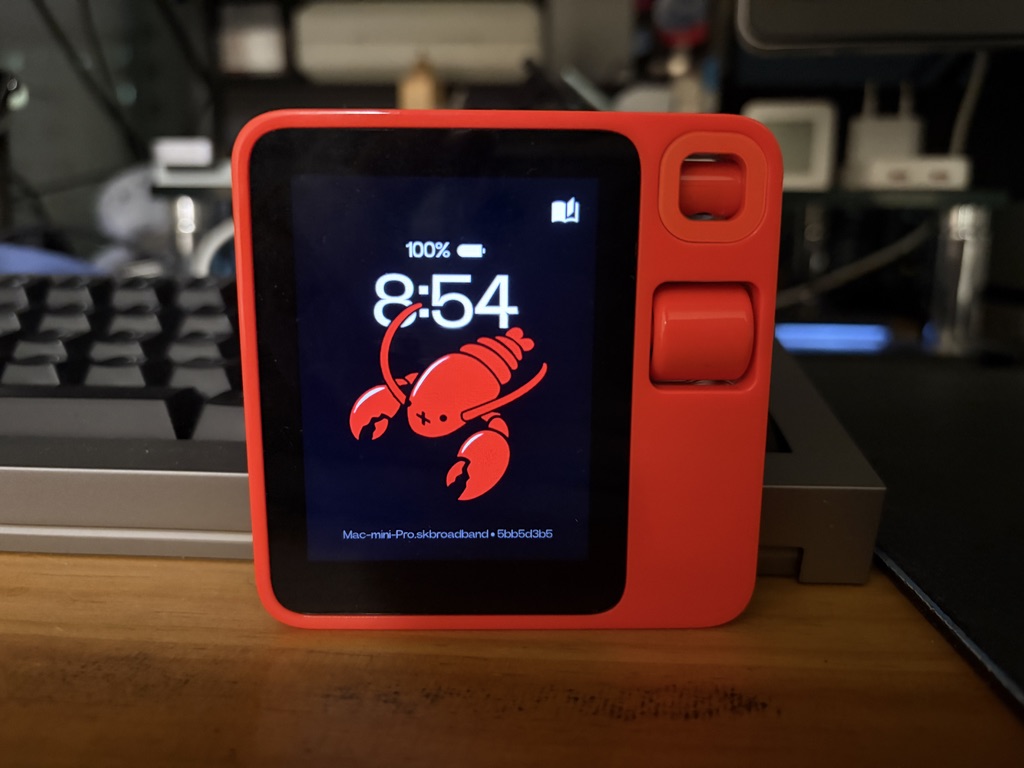
rabbit r1 근황

근황… 이라는게 맞는 표현인지는 모르겠지만,
AI 디바이스의 미래로 추앙받다가 제품이 풀리고나서 사기로 맹 비난 받았던
Rabbit R1 이라는 제품이 있었지요…
(그리고 그 옆에는 이제 모두의 기억에서 사라졌던 Humane AI Pin 도 있었습니다…)

Picture from WIRED

일단은 뭔가 있어보이는 외형과 막 뜨던 LLM hype의 상승효과로 이거 하나가 막 손안에 있는 AI로 모든걸 해줄 것 같은 기대감을 잔뜩 불러 일으켰는데… 저만 그런건 아니었는지 CES 2024에서 공개되자마자 하루만에 1만대 예약을 받아버리는 기염을 토하게 됩니다.
뭐 저 역시 이런거 못참는 병이 있어서 (블베병 옆에 얼리어답터병 옆에 합병증으로 오는 그런거 있어요.) 덥썩 예약구매까지 하는 덕분에,
당시 $199라는 거금을 덥썩 써버렸지만 $200 상당의 퍼플렉시티 1년 사용권을 줘서 뭐… 퍼플렉시티를 잘 썼던 기억이 납니다. 네.

그리고서는 뭔가 힙하디 힙한 런칭 파티 이후 소프트웨어가 사실은 알고보니 안드로이드에 껍질 씌워놓은 것에 불과했고, 다른 서비스랑 연결해주는 ‘rabbithole’이라는 사이트?는 개인정보 따위 쌈싸먹는 구조로 온갖 서비스 연동을 쌩으로 하게 만들어 놓은데다가 구린 카메라와 굼뜬 하드웨어의 환장의 콜라보로 기대를 갖고 있던 사람들에게 대 실망을 안겨주고 쓸쓸히 사람들의 기억속에서 잊혀져 가고 있었습니다. 심지어 AI 기능이라고 넣어준 것들 역시 AI 모델들을 api로 연결해준 것 정도의 장난감 스러운 기능 정도였으니 실망이 이만 저만이 아니었죠.

아니, 저만 그랬나봐요.

바로 GG 치고 게임에서 나가버린 Humane하고 다르게, 이미 팔린 하드웨어가 있어서인지 계속해서 업데이트를 해 나가고 있었네요. 25년에는 지금의 에이전트 류들이 하는 것 처럼 ‘인턴’이라는 기능을 내면서 뭔가 계획도 세우고 리서치도 하고 코딩도 해주겠다고 하는 야심찬 계획을 발표합니다… 만 잘 모르겠네요.
(그냥… 또 하나의 LLM 채팅 인터페이스 같은 화면인데… )


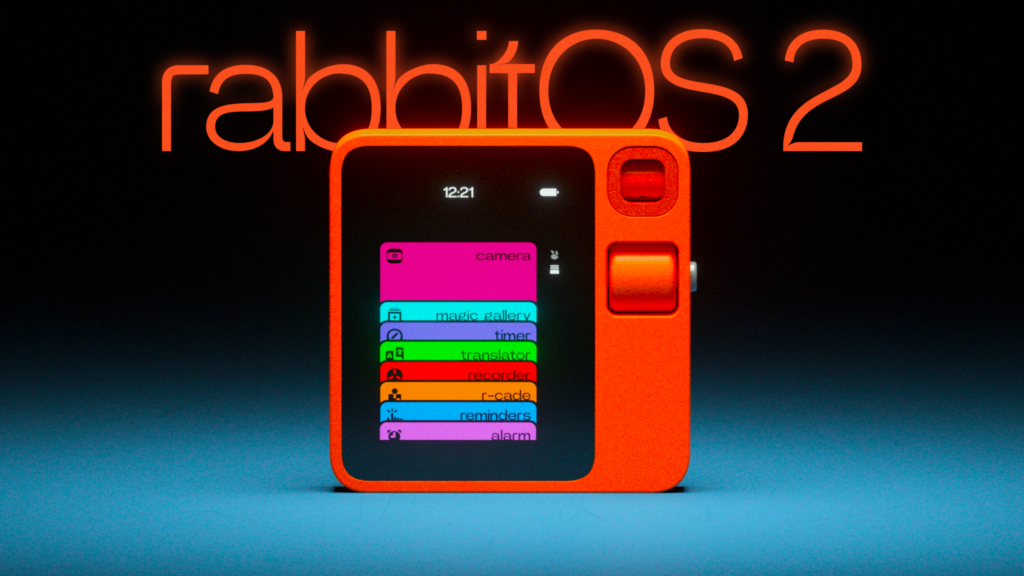
그리고 9월에는 ‘rabbitOS 2’를 런칭하면서 ‘카드 기반 인터페이스와 음성 코딩 기능을 갖춘 선구적인 소비자용 다중 에이전트 시스템’이라는 한 번에 이해하기도 어려운 캐치 프레이즈를 내걸면서 기본 OS를 과감하게 다 뒤집어 버리고 디스플레이에 맞춘 카드 형태의 앱들과 음성 중심으로 사용성을 개선하겠다고 발표합니다.

이게… 25년의 마지막 한 방…

그리고, 26년.
세상이 openclaw와 하네스를 거쳐 ‘에이전트’에 열광하고 있을때,
‘아니… 저 조그만거에 텔레그램마냥 대화 채널 하나만 뚫어주면 좀 더 요긴하게 써먹을 수 있지 않을까?’라는 생각을 저만 한게 아니었는지, rabbit 도 이 에이전트 분위기에 올라타는 걸로 방향을 과감하게 바꿉니다. 전 처음에 그들도 에이전트를 하겠다고 한 줄 알았었는데, 아니었나 봅니다 .

그래서 내놓은게 연동 기능. 오픈클로와 클로드를 연동해서 대화를 계속 진행하도록 해줍니다. 최근에는 Hermes도 연동이 가능해졌어요.

사용은 간단합니다.
현재 오픈클로나 Hermes, Claude Code가 깔려있는 컴퓨터에서
rabbithole (https://hole.rabbit.tech/) 사이트에 접속 한 다음,
node 연결 설정에 들어가서 ‘rabbit agent’라는 앱을 다운 받아 설치해주면 됩니다.


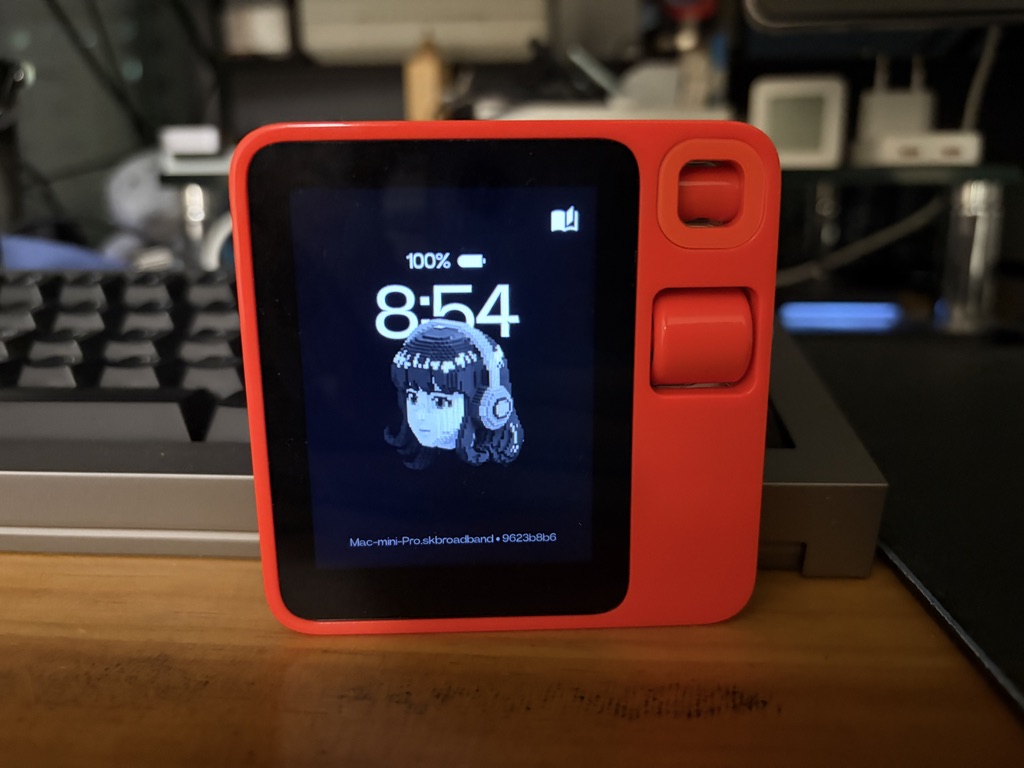
그럼, 짜자잔~

사용은 간단합니다. 저 상태에서 오른쪽 버튼 누르고 말하면 그걸 열심히 받아적어서 에이전트에게 넘겨주고 조금 기다리면 답변이 날아오는 그런거죠.
(네, 텔레그램으로 하고 계시던 그거요…)
물론, 그 안에서는 ACP라고 에이전트 간 통신 표준 프로토콜을 사용해서 접속하는 식으로 나름의 첨단(?) 기능을 활용하는 거긴 합니다. 그러고 보니 얘도 Agent 호소 기기 였었네요.

처음 받고 제일 실망이 컸던게 당시 AI Model의 한계로 한국어 음성 인식이 불가했다는 점이었는데, 지금은 (모델의 급속 성장 덕분에) 매우 깔끔하게 잘 알아듣는 모습을 볼 수 있었습니다. 또, 응답 내용은 텍스트로도 보여주지만 음성으로도 읽어줘서 나름 편리합니다.
(chatGPT 음성 모델 쓰는건지 그 교포 발음스러운 한국어 느낌이 물씬 풍깁니다.)
다만, LLM들이 수다쟁이라 뭐 하나 던지면 답변이 한 바닥이 나오는데 저 작은 화면으로 계속 스크롤 넘기면서 보는 것도 힘들고 음성도 언제 끝날줄 모르게 계속 읽는걸 듣고 있어야 한다는 것도 쉬운건 아니더라구요.

방향을 90도 틀어서 카메라쪽을 아랫쪽으로 해서 들면 키보드가 나오는 화면으로 바뀌는데… 한국어 입력은 안되어서 이 역시 무용지물입니다.
사진 찍어서 넘길 수도 있는데 해상도가 참으로 저렴해서 글씨 판독은 불가한 수준이고 화면에 뭐가 보이는지 정도 물어보면 지레짐작해서 알려줍니다.

뭔가… 방향을 찾았다고 보기 애매한데요… 다른 사람들은 지금 이걸 어떻게 쓰고 있는지 모르겠네요. 사실 간단한 질문 (날씨나, 버스 도착 시간이나 등등) 에 대해서 굳이 타이핑 하느니 얘 눌러서 답변 받으면 좋겠다고 생각한건데… 생각만큼 매끄럽게 돌아가지 않아서 좀 아쉽다는 생각이 더 크게 듭니다. 특히 제가 쓰고 있는 서비스에 또 하나의 채널로 활용하는 건 그 활용도가 극히 적어질 수 밖에 없는 한계가 있지 않을까 생각했는데, 그 생각보다도 더 빠르게 활용도의 벽에 부딪히는 순간이 오게 된다는 점을 확인하게 된 것 같아서 아쉽네요.

뭔가… 이런 류의 하드웨어가 받는 근본적인 질문이 ‘스마트폰이 있는데 왜?’ 라는 질문에 여전히 답을 하지 못하는 상황인게 변함 없는 것 같아요. 심지어 그 젤문에 답을 하기 위해 굉장히 여러가지 시도를 하고 있음에도 불구하고 말이지요.

openAI가 올해 말 아니면 내년 초에 내놓을 것으로 예상하는 새로운 하드웨어는 뭔가 다른걸 준비해서 나오게 될까요?

Lofree Hyzen 수령

또 키보드를 샀다고?

그렇다. 이미 집에 키보드는 차고 넘치게 많다. 전설적인 명기로 추앙받는 로지텍 K810도 있고, 로지텍 Mechancial Pro도 있고, 8bitdo SNES 테마 키보드 (A, B 큼지막한 키도 따로 주는 그거…) 도 있고, 마이크로소프트 웻지 키보드도 있고…. 에… 사무실엔 키크론 K2 HE 키보드도 있고… 등등 더 있지만 일단 집에는 이 정도. 그럼에도 또 사버렸다.

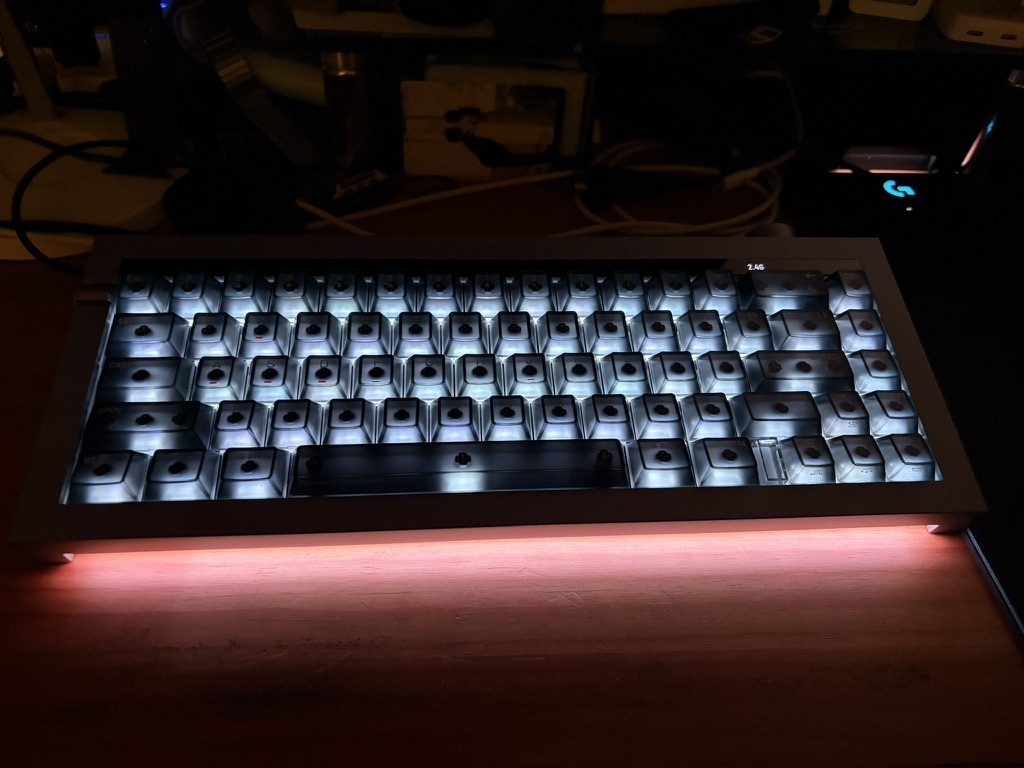
솔직히 저 테슬라에서 영감을 받았다고 당당히 밝히는 하단 간접 조명을 보고 어떻게 참을 수가 있단 말인가.

암튼, 그리하여, 킥스타터 펀딩 이후 잊어버리고 살다가 갑자기 메일로 주소 넣으라고 하더니 또 감감 무소식이었다가… 갑자기 CJ 택배가 집앞에 도착했다. 다 찌그러진 박스에 담겨있어서 ‘아니 고객님의 소중한 택배를 이렇게 험하게 다루다니!’하고 잠깐 분노했으나, 들어보고 알았다. 디지게 무겁구나.

게다가 택배 배송용 박스 안에는 제품 박스가 있었고, 그 안에는 파우치 혹은 캐링 케이스 라고 불러야 할지 뭐라 해야할지 모를 타원형의 무언가 하나만 덜렁 들어있다보니 박스가 제 형태를 유지하고 있기를 기대하는건 매우 힘들겠다…라는 생각이 들었다.

첫 느낌

Lofree Hyzen은 기계식 스위치와 자석축 스위치를 전환해 가면서 쓸 수 있다는 점을 자랑으로 내세우는 키보드인데, 일단 기본 설정은 기계축이다. 뭔가 독거미 경해축 혹은 그보다 조금 더 가벼운 키감을 주는데, 나름 단단하게 잡아주는 묵직한 키보드 본체 덕분인지 혹은 개스킷을 엄청 빵빵하게 집어 넣어서 그런지 텅텅 울리거나 하는 불쾌한 느낌은 주지 않는다. 뭔가 독거미 키보드나 그 대항마 로지텍 알토키 K98M은 치다보면 뭔가 텅텅 울리는 느낌이 손끝에 다시 피드백이 오면서 팔 전체 혹은 몸에 좀 불편한 울림이 전달 되는 기분이 들어 피곤함이 들게 되는데, 일단 아직까지 Hyzen은 그런 느낌은 없다.

자석축으로 변경하면 키감 자체는 키크론 K2 HE와 크게 다르지 않은 느낌인데, 아직 설정을 제대로 안해서 그런지 키가 중복으로 눌리거나 순서가 바뀌어 눌리는 등의 자잘한 튐(?) 들이 있다. 아무래도 넥서스 스위치의 특징이거나 혹은 무선 리시버의 폴링레이트를 너무 과하게 잡았거나 (8000Hz!!) 한 듯 한데… 이건 세팅을 좀 만져가면서 살펴봐야 할 것 같다. 이른바 구름타법으로 쓰기에는 자석축이 최적인듯 한데, 일단 당분간은 기계식으로 놓고 써야할 듯.

내가 산 건 Trimode라고 케이블/블루투스/2.4G 무선 세 가지 방식으로 연결이 가능한 모델인데. 리시버 (앞서 올린 사진 오른쪽 위에 있는데, 이 것 역시 간접 조명(!)을 쏜다.) 연결하면 바로 키보드는 인식되고 사용 가능하다. 키보드 좌측에는 숫자키열을 F1~F10 등의 펑션키로 변환하는 스위치가 있고(스위치를 올리면 숫자키 윗쪽에 각 키에 해당하는 다른 기능이 켜진다) , 키보드 우상단에는 모드 전환 레버 (케이블/Off/무선(2.4G/BT))와 볼륨 조절 노브 (엄청 큰 다이얼이 볼륨 조절 밖에 안되다니…)가 있다.

키 배열에서 가장 큰 단점…이라고 하자면… ~/` 키가 없다는것. Fn 키와 Fn+Shift를 누르면서 ESC키를 누르면 두 문자를 입력할 수 있는데… 한국 사람이라면 물결키는 필수인데… ‘End’ 키가 없는건 맥에서는 어차피 못쓰던 키라 상관 없다 하지만 맥과 윈도우를 오가면서 쓰는 내겐 조금 불편한 부분인건 좀 아쉽다.

외관은 마치 테슬라 사이버트럭과 비견할 만하다. 은색 알루미늄 바디의 각진 모습이나 거기에 포인트로 들어간 검은색 상태창? 도 그렇고, 하단 간접조명도 테슬라 후미등이 계속 생각나게 만드는데다, 묵직함을 넘어서 육중한 무게의 본체를 놓고 보자면 더더욱 테슬라가 주는 느낌을 이 키보드에서도 받게 된다.

소프트웨어

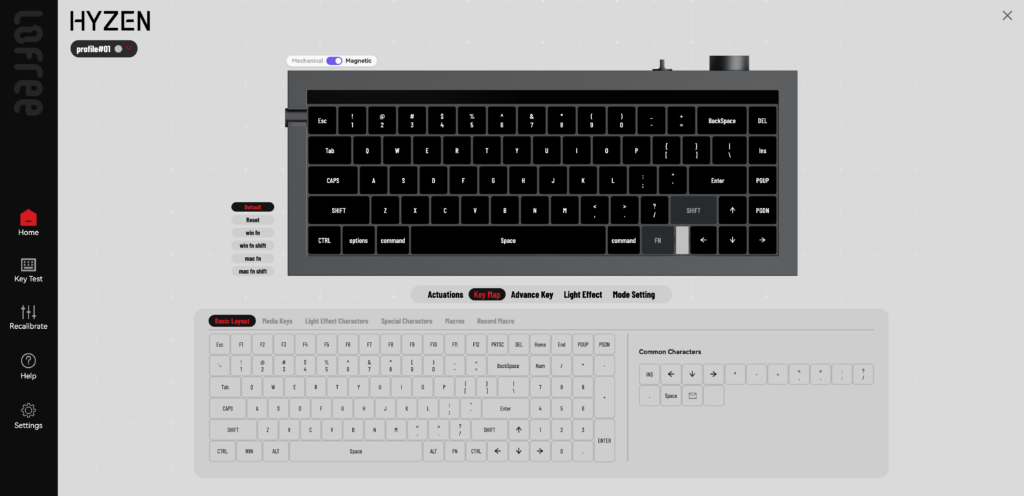
Keychron에서도 사용하는 방식인 웹페이지 형식의 설정 페이지

이 설정 앱… 아니 웹. 접속이 크롬에서만 된다. 사파리도 파이어폭스도 ‘로딩중’ 표시만 뜨고 안되어서 뭔가 오늘 전 세계 신청자들이 다 한날 한시에 받게 되어 지금 세팅하느라 난리가 난건가. DDOS 공격 당하는건가. 라는 생각을 했지만 아니었다. 크롬에서만 된다.

세팅은 같은데서 만든거 아닐까 싶을 정도로 유사하다. 자석축 세팅으로 하면 키 별 동작 기준을 정하는 ‘Actuation’ 메뉴가 활성화 되는 것 외에는, 윈도우/맥 용 키 셋팅이나 펑션키 누르면 추가 동작하는 것들에 대한 설정, 조명 설정, 게이밍 키보드에 있는 윈도우키, Alt+f4 등 불의의(?) 동작을 막아주는 설정 등이 있다.

이 부분은 아직 본격적으로 살펴보기 전이라 나중에 기회되면 좀 더 자세히 설명을 풀어보도록 하자.

그래서…?

초기에 유튜버들 중심으로 바이럴 마케팅을 열심히 한 탓인지 실제 제품 받고 조금 기대와 다른 부분에 대해서 이런저런 말들이 나오기도 하는 모양이다.

나 역시도 아직까지는 뭔가 이 제품만이 주는 장점은 외관 정도 밖에 없는 것 같아 좀 아쉽지만, 당분간 계속 써가면서 좀 더 느껴보고자 한다. 언제가 될지는 장담 못하지만…

Synology NAS Migration

오래썼다, DS416j

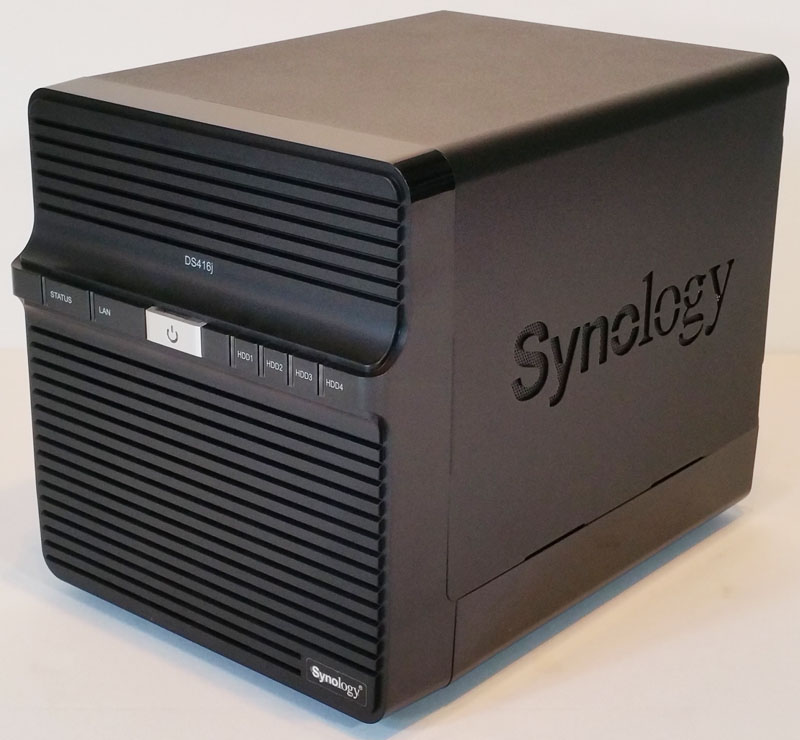
4베이의 위용을 자랑하는 이 늠름한 모습을 보라

시놀로지 NAS는 모델명 붙이는 규칙이 있다.

이를테면,
– DS는 DiskStation으로 개인용 NAS에 붙는 이름이고,
– 여기에 숫자 첫 자리는 최대 확장 가능한 하드디스크 숫자,
– 뒤에 두자리는 처음 선보인 년도,
– 마지막은 성능/특화 모델 표시로 구분된다.

이를테면, DS416j는 개인용 NAS인데, 하드디스크는 4개까지 꽂아 넣을 수 있고, 16년에 나왔으며, 입문용으로 약간은 저사양으로 나온 모델이라는 뜻이란다.

2000년 초반에 아직 클라우드라는게 익숙치 않던 시절부터 개인용으로 하드디스크 하나 들어가있는 NAS를 써오다가 아이 사진 보관용으로 좀 제대로 된걸 사보자고 해서 큰맘먹고 들인건데,
느리긴 하지만 본연의 역할은 충실하게 해내준 고마운 녀석이었다.

암튼, 이제는 팬도 맛이 가서 하드디스크 고온으로 꺼지는 일이 생기면서 이러다 데이터고 뭐고 다 날아가버리겠다는 생각에 새로운 NAS를 찾게된다.

몇 가지 조건, 그리고 결론.

DS416j의 디스크 구성은 SHR로 묶어둔 5TB 하드디스크 2개를 미러링 해서 사용 중이었다. 이미 3.5GB정도를 사용 중이기도 했고, 요즘 램이건 SSD건 하드디스크건 가격이 하늘높은줄 모르고 치솟는 중이라 추가 디스크 구매는 지양하는 방향으로 정해졌다. 아니 정했다.

디스크 베이는 크게 많을 필요는 없다고 생각했다. 4베이 다 채워 본 적도 없었던데다가, 혹시 열관리에 도움될까 해서 슬롯도 중간에 한 칸 비워서 설치했는데도 딱히 열관리에 이점을 얻지도 못해 디스크온도가 50도 근처에서 계속 머물러 있기도 했고. 게다가 가격이…

암튼, 요즘 NAS 동네는 어떤가 하고 좀 살펴보다보니 자연스럽게 후보는 셋 정도로 추려졌다.

  1. 시놀로지
  2. Ugreen
  3. 무모한 도전

1. 시놀로지 – 건드릴게 가장 적은 선택

생태계라고 하면 좀 거창하지만, 이미 시놀로지 앱에 많은 부분을 기대고 있는 중이긴 했다.
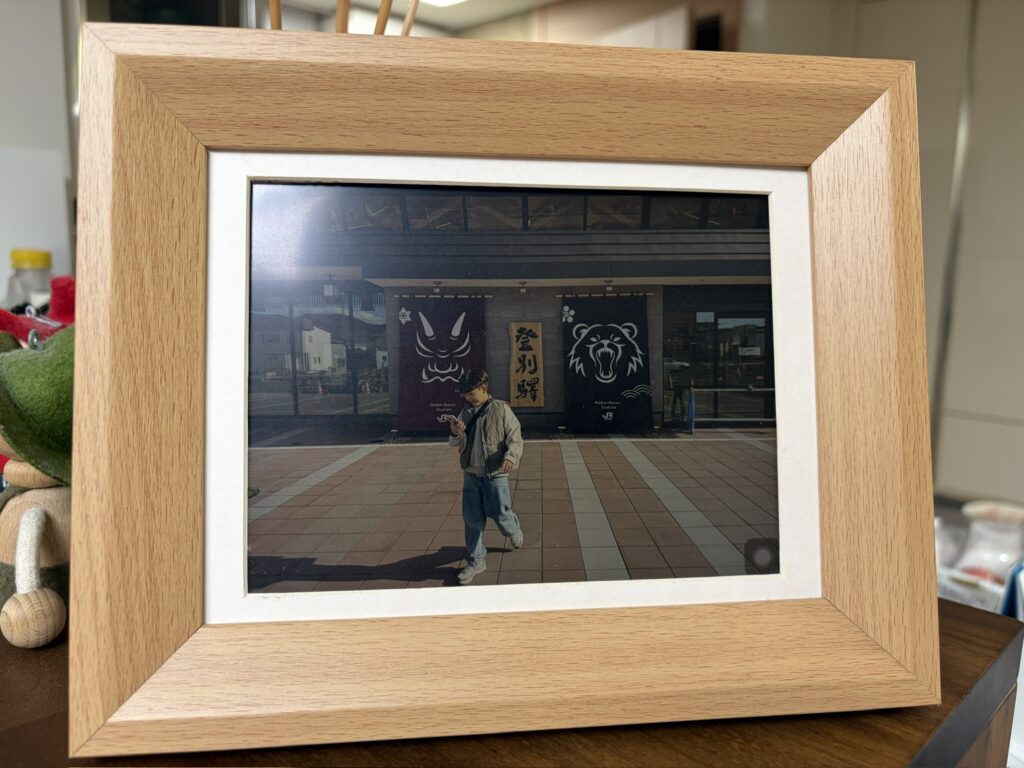
특히 시놀로지 포토 앱으로 나랑 부인님 핸드폰의 사진데이터를 계속 백업받고 있기도 했고, 또 그걸 안쓰는 아이패드 미니를 디지털 액자마냥 나무 프레임에 넣어두고 여행 다녀온 사진들 슬라이드쇼 시키면서 띄워놓고 있는게 은근 만족도가 높아서 이걸 대체하는게 가장 큰 걸림돌이었다.

열일중인 ipad mini 5. 액자 프레임은 광고보고 꽂혀서 바로 질렀는데 파는 곳은 이미 없어진듯. 밤에도 그냥 켜두다보니 밝기를 많이 낮춰놔서 어두워보인다. 노보리베츠 온천은 정말 좋았다.

2. UGREEN – 신흥 강자?

사실 시놀로지가 조금 괘씸(?)했던게, HDD를 시놀로지에서 판매하는게 아니고서는 아예 못쓰게 하는 정책을 내놓았다는 점이다. 물론 전세계인의 하나된 목소리로 욕을 해대니 해당 정책은 철회하긴 했지만. 아직도 캐시용으로 사용하는 SSD는 시놀로지 제품 아니고서는 설치/적용이 안된다. 그렇다고 해서 뭔가 다른것도 아니고 그냥 택갈이만 해서 나오는 제품을 강제하는건 정말 양심리스한 모습이라 조금 정이 떨어지긴 했다.

그래서 시놀로지를 벗어난다고 할 때, 사람들이 최근 가성비 등등을 따져 가장 많이 언급하는게 UGREEN 이었다.

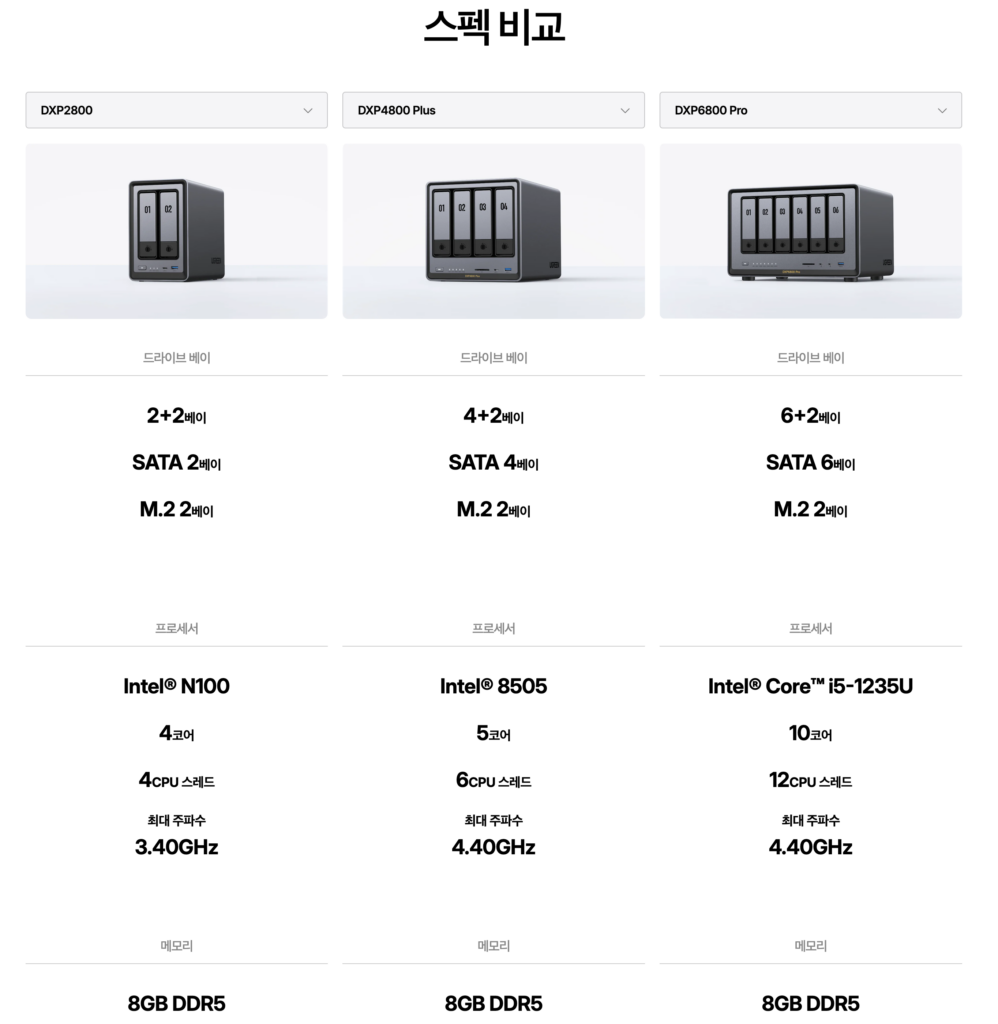
정말… 스펙만 놓고 보면 최강인듯…

DS416j는 탐색기나 앱을 통해서 파일을 직접 활용하는데는 큰 문제가 없었지만, 사진 올린 뒤 색인에 걸리는 시간이나 관리 페이지에 접속하면 화면 뜨는데 세월아 네월아 하고 있던걸 생각해보면 절대 보급형 CPU와 모자란 RAM은 피해야겠다는 생각이 강하게 들게 되는데, 이 놀라운 스펙이라니. 세상에.

다만 찾다보니 너무 단촐한 소프트웨어가 계속 발목을 잡는다는 점과 아무래도 NAS 전문 브랜드가 아닌데서 오는 왠지모를 찝찝함, 그리고… 최근 너무 올라버린 가격때문에 고민이 되는 부분이었다.

3. 무모한 도전? – 이왕 켜놓는 시스템이라면…

요즘 맥미니에 로컬 LLM 올려서 돌리는 재미가 쏠쏠해 있던 차에, 문득 스치고 지나간 광고가 하나 있었으니…

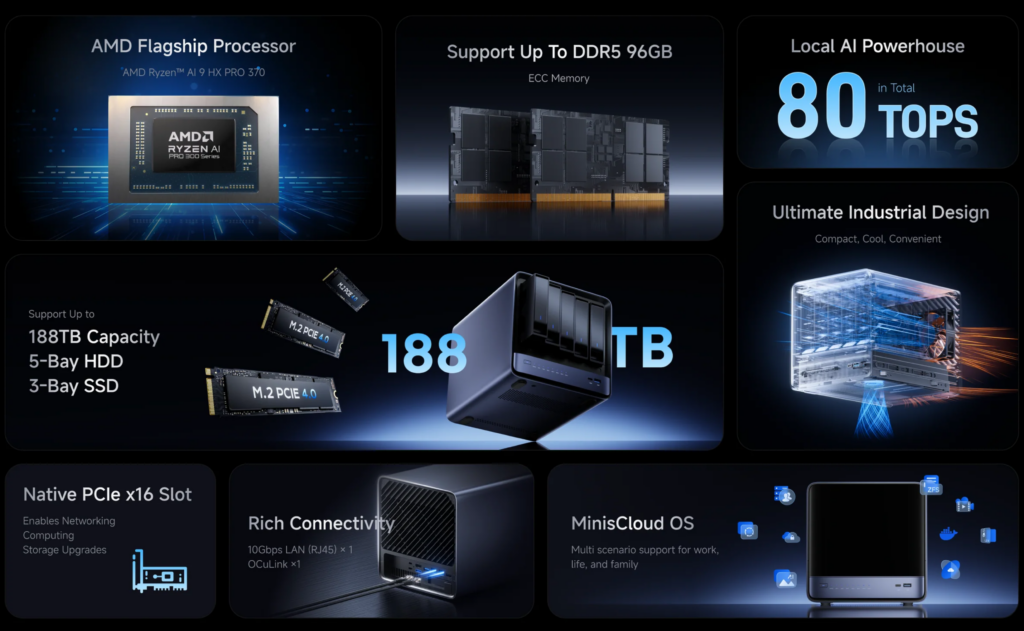
지금봐도 NAS보다는 그냥 워크스테이션 광고인듯. NAS로 쓰기엔 한참 오버스펙.

Minisforum N5 Pro 되시겠다. CPU가 무려 HX Pro 370. 메모리는 통합메모리로 96GB까지 설치 가능하다 그러고, Oculink까지 있다. 이쯤 되면 하드디스크 몇 개 꽂고 용량 얼마까지 지원하고 하는 말들이 다 귀여워보인다.

사실 가장 솔깃했던 건, 혹시 그럼 여기다가 Local LLM 돌릴 수 있는거 아닐까? 하고 봤던건데… 이미 외쿡 형님중에 굉장히 자세한 리뷰를 써주시면서 이 부분까지 긁어주신 분이 계셨다.

https://www.reddit.com/r/homelab/comments/1obf9s6/minisforum_n5_pro_ai_nas_reviewproject/

결론은 꽤 쓸만해 보인다 였는데… 뭔가 설정까지 가는 길이 매우 험난해 보여서 패스. 그리고 지금은 구하려고 해도 씨가 말라서… 게다가 96GB의 DDR5 ECC메모리 값은…

결국 돌아돌아 결론은 제자리

그렇다. 이리보고 저리봐도 지금 사용성이나 가격을 놓고 보면 시놀로지를 벗어나는 것은 대안이 되어주질 못하는 상황이다. 컴퓨팅 파워와 광활한 메모리를 자랑하며 나온 대항마 NAS들은 그게 발목을 잡아버리면서 환율과 메모리가격의 이중고에 시달리면서 사정권에서 광속으로 멀어져갔다.

그래서, 내가 내린 결론은…

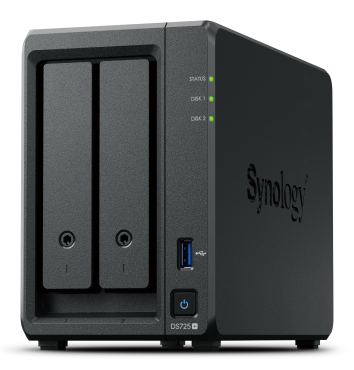
DS725+ 다.

일단, 시놀로지 제품 중 비교군이던 DS225+에 비해 AMD 칩셋을 쓰면서 4GB의 메모리를 달고 있다는 점이 장점이었고, 회사에서 지원금이 나오는 복지몰에서 구할 수 있는 NAS라는 점이 아주 강력하게 작용했다. (QNAP이랑 시놀로지밖에 없었…)

게다가 무엇보다도, 기존 HDD를 그냥 그대로 가져다 쓸 수 있다는 점이 아주 강력한 플러스 요인이었다.

마이그레이션

뭐 사실, 사전에 조사하기로는 CPU 아키텍쳐가 달라서 (Armada vs. AMD R1000) 안된다 부터 되긴 하는데 싹 다 지워야해, 되는데 설정은 다시 해줘야 함 등등 검색결과와 그 결과를 들고온 AI마다 얘기가 달라서 고민이 되는 부분이었는데…

에라 모르겠다 하고 설정만 로컬에 백업해두고 하드 옮겨 꽂았더니…
바로 기존 내용 인식하고 마이그레이션도 별 말 없이 그냥 진행되어버리면서 익숙한 화면이 그대로 나왔다. 로그인도 기존 계정 그대로, OTP도 기존 설정해둔 앱 통해서 그대로 되고. 이름도 기본 셋팅도 설정했던 그대로.
정말 그간의 고민이 허무할 정도로 쉽게 끝나버렸다.
(얼마나 금방 끝났냐면, 따로 화면 캡쳐 할 정신도 없을 정도로 후루룩 지나가 버렸…)

다만 이렇게 된 배경에는, DS416j가 그나마 올 해 까지 DSM 업데이트를 받으면서 7.4버전으로 올려놓고 진행한 점이 다행이었던 것 같고, 이런저런 모듈들/앱들 설치 안하고 쓴 덕분이기도 한 것 같다.
실제로 Synology Photo는 계정 별 공유 앨범 설정 등이 사라졌고, 색인도 다시 해줘야 하는 불편함이 있긴 했다. 하지만 뭐 이정도는…

근데 이제 어떻게 끝을 내지…

여튼 폭풍같은(;;) 마이그레이션도 마치고, 이제는 평온한 일상으로 돌아오고, Photo 관련 설정도 다 마치고 이것저것 달라진것 없는지 살펴보는 중이다.

같은 DSM 7.4 버전이긴 했지만 DS416j 에서는 패키지 설치 단계에서 부터 안보이던 것들이 보여서 (대표적으로 Docker 관련…) 이걸 어떻게 잘 써먹어 볼지 살펴보는 중이다. 혹시 쓸만한 기능 찾게되면 추가로 올려보면 좋겠다. 미래의 나여, 혹시 모르니 뭔가 할 때 캡쳐 잘 하면서 해라.
(하지만 이미 Home Assistant 추가하는걸 캡쳐 없이 그냥 해버렸…)