얼마 전 Strata로 Qwen3.8-Flash-Next를 돌려본 이야기를 올렸었다. 평범한(?) 오래된(…) 게임용 PC에서 이 체급의 모델을 초당 수십 토큰으로 돌릴 수 있다는 것만으로도 꽤 신기했는데, 깃헙 새로고침을 하다 보니 이번에는 DeepSeek V4.1-Flash 지원이 들어왔다.
Qwen도 아니고 DeepSeek를? 그 수백 기가짜리 모델을 내 컴퓨터에서? 이건 또 안 눌러볼 수가 없다. 물론, 돌아간다는 것과 쓸 만하다는 것은 전혀 다른 이야기라는 걸 이번에도 다시 확인하게 됐지만… 일단 업데이트부터 해봤다.
이번 업데이트는 DeepSeek, 다만 엔진은 별도입니다
Strata 0.2.4 릴리스에서 DeepSeek V4.1-Flash 지원이 추가됐다. 정확히는 터미널의 strata launch, strata setup을 통해 설치하고 실행하는 방식이다. 이번에 배포된 데스크톱 앱 자체는 0.2.3으로 유지되고, DeepSeek 선택 기능은 아직 들어가지 않았다고 한다. 앱이 지원되면서 확실히 편해지긴 했지만, 거기에서 업데이트랑 모델 목록만 찾고 있으면 조금 헷갈릴 수 있는 부분. 뭐 그래도 금방 업데이트 되긴 할 듯.
기존 Qwen 엔진이 DeepSeek까지 같이 돌려주는 것은 아니고, strata-dsv41이라는 별도 엔진을 나란히 설치한다. Qwen 엔진을 덮어쓰는 구조는 아니다. 모델은 ISTA-DASLab의 양자화 버전을 사용하고, 자주 쓰는 expert는 RAM에 두고 나머지는 SSD에서 읽어오는 방식이라고 한다. 결국 VRAM만으로 안 되면 RAM과 SSD까지 총동원하는 Strata 구조를 확장해서 적용한 셈이다.
공식 안내상으로는 12GB 이상 그래픽카드에 RAM 46~64GB 정도로도 실행이 가능하다. 조건은 2bit 양자화 모델일 때 그렇고 양자화를 조금 올리면 SSD 사용이 더 많아진다. 다만 작아졌다는 모델조차 다운로드 용량이 양자화 종류에 따라 239~274GB다. 메모리에 다 올리지 않아도 된다는 뜻이지, 모델 자체가 갑자기 가벼워진 것은 아니다. SSD 여유 공간부터 확인해야 한다.
30시리즈와 50시리즈 사이에서 사라진 내 4080
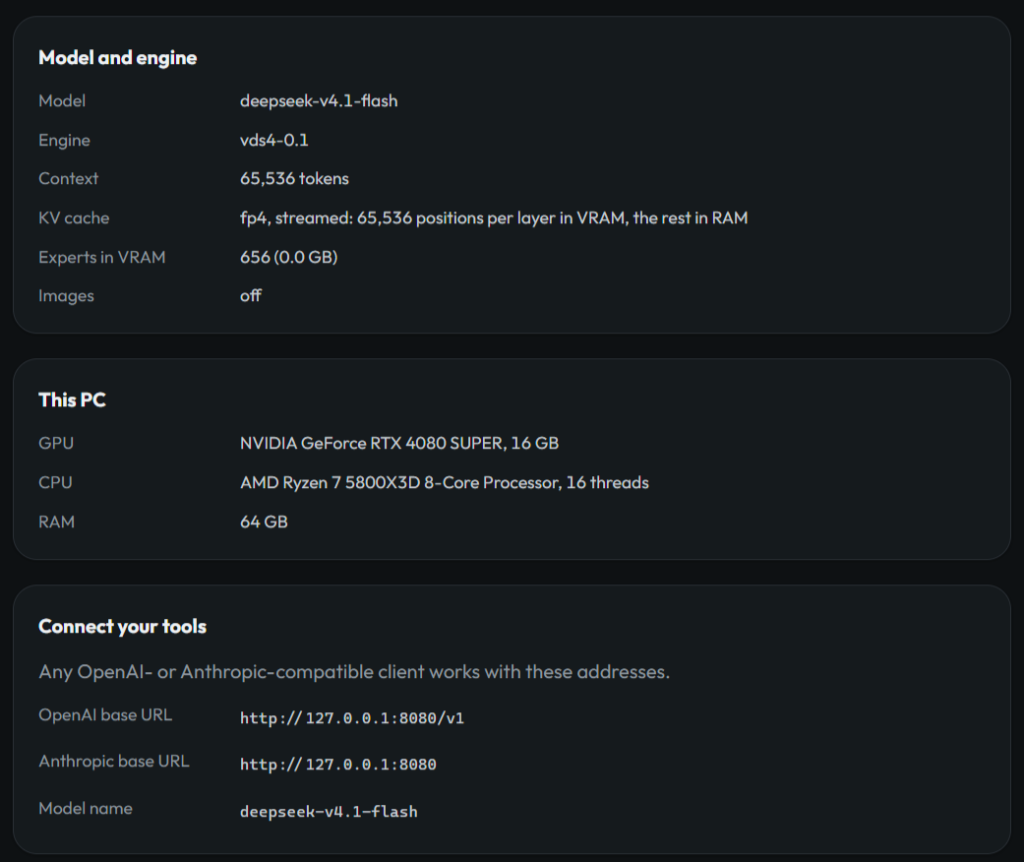
이번에도 예전에 Qwen을 돌렸던 PC를 그대로 사용했다. Ryzen 7 5800X3D, RAM 64GB, RTX 4080 SUPER 16GB 구성이다. 아직 게임용으로도 충분히 현역인 장비인데, 로컬 LLM 앞에서는 늘 뭔가 모자란 기분이다.
업데이트를 적용하고 DeepSeek를 설치하려는데 여기서 한 번 걸렸다. terminal로 설치를 안했다보니 앱하고 별개로 그냥 새로 설치하려했는데, 이 똑똑한 설치스크립트가 기존 설정을 그래도 어느정도 읽어온다. 그런데 자동 설치 과정에서 RTX 30시리즈와 50시리즈만 지원되는 것처럼 나오고, 정작 그 사이에 있는 40시리즈인 내 4080 SUPER는 지원되지 않는다고 나오는 것. (똑똑하다는 말 취소…) 아니, 30도 되고 50도 되는데 40은 어디로 간 건가요… 분명 30 to 50이랬는데, 확인만 3090과 5070에서 했다고 했는데…
다행히 이건 40시리즈에서 아예 실행할 수 없다는 뜻은 아니었다. 공식 릴리스의 NVIDIA용 DSV 엔진 지원 목록에는 RTX 30 / 40 / 50이 모두 들어 있다. 내가 설치하던 시점에는 자동 설치 쪽에서 지원 불가로 표시되는 문제가 있었던 셈이다. 어떤 내부 판정에서 꼬였는지까지 확인한 것은 아니니, 40시리즈 미지원이라고 단정할 일은 아니다.
다행히도 똑똑하진 않지만 친절한 설치스크립트는 따로 엔진을 받아서 설치하면 된다고 안내가 나온다. 영어로 써있어서 처음에 무시했던게 그런 내용이었던 것. 그래서 GitHub 릴리스에서 별도의 strata-dsv41 엔진 패키지를 직접 내려받아 설치하는 것으로 넘어갔다. 공식 문서에도 자동 설치 외에 수동 패키지를 지정하는 --dsv41-package 옵션과 engine-dsv41 폴더를 사용하는 방법이 안내돼 있다. 비슷한 메시지를 만나면 그래픽카드 탓부터 하기 전에 릴리스의 DeepSeek 엔진 패키지와 수동 설치 안내를 확인해보는 편이 좋겠다. 운영체제에 맞는 NVIDIA CUDA 패키지를 고르고, 함께 제공되는 체크섬도 확인하는 것이 기본.
우여곡절 끝에 모델이 올라왔고, 아래처럼 DeepSeek V4.1-Flash와 내 PC 사양이 정상적으로 표시됐다. 컨텍스트는 시험이니 작게 가려다 괜찮으면 바로 webui에라도 물려볼 요량으로 65,536 토큰으로. 일단 실행 성공이다.
돌아갑니다. 그런데 이제 속도가…
실행해서 요청을 던져본 결과는 아래 화면과 같다. 모델이 응답을 만들고 요청을 끝내는 것까지는 확인했다. 다만 이번 글은 답변 품질을 여러 문제로 검증한 벤치마크라기보다는, 내 PC에서 얼마나 현실적으로 돌릴 수 있는지 확인해본 찍먹 후기에 가깝다.
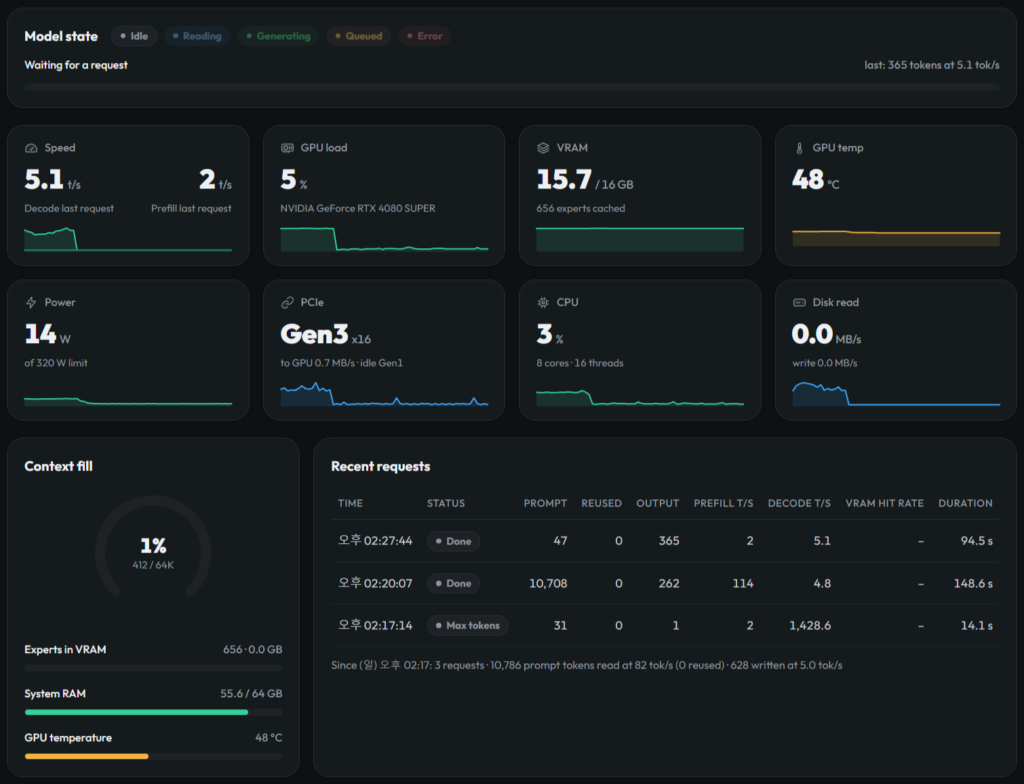
돌려보며 확인한 속도는 프리필 약 110t/s, 생성 약 5t/s 수준. 프리필은 입력한 프롬프트를 읽는 속도이고, 생성은 실제로 답변 토큰을 뽑아내는 속도다. 두 숫자는 따로 봐야 한다.
물론 요청마다 수치는 달랐다. 첨부 화면의 긴 요청은 입력 10,708토큰에 프리필 114t/s, 생성 4.8t/s로 표시돼 있고, 다른 완료 요청의 생성 속도는 5.1t/s다. 그러니 110t/s가 모든 상황에서 고정으로 나오는 성능이라는 이야기는 아니다. 전체적으로는 입력을 읽는 데도 기다림이 있고, 답변은 초당 다섯 토큰 남짓으로 흘러나오는 정도라고 보면 된다.
5t/s면 단순 계산으로 1,000토큰을 만드는 데만 200초, 3분이 넘게 걸린다. 프롬프트를 읽는 시간은 별도이고, Thinking까지 길어지면 내가 보고 싶은 최종 답변을 만나기까지는 더 기다려야 한다. 가끔 한 번 질문하고 다른 일을 하다 오는 용도라면 몰라도, 답변을 보고 다시 묻고 코드를 고치는 식으로 계속 주고받기에는 꽤 답답한 속도다.
공식 릴리스에도 12GB 카드의 생성 속도는 대략 4~8t/s 수준이고, SSD와 CPU의 영향이 크다고 적혀 있다. 내 결과가 곧 DeepSeek 자체의 한계라거나 RTX 4080 SUPER 전체의 대표 성능이라는 뜻은 아니다. RAM, CPU, 저장장치, 모델과 설정이 같이 얽히는 방식인 만큼, 여기서는 어디까지나 내 환경에서 나온 결과로 봐주시면 된다.
되긴 하는데, 매일 쓰기는 어렵겠다
이 체급의 DeepSeek를 서버도 아닌 집에 있는 PC에서 실행했다는 것 자체는 분명 대단하다. 수백 기가짜리 모델을 VRAM, RAM, SSD에 나눠서 어떻게든 굴러가게 만드는 개발자들의 집념에는 이번에도 감탄하게 된다. 공짜로 풀어주신 것만으로도 감사할 일이고.
하지만 예전 Qwen 때의 “어? 이 정도면 써볼 만한데?”와는 느낌이 다르다. 프리필 110t/s 안팎에 생성 5t/s로는, 적어도 내가 기대하는 실제 활용에는 무리가 있어 보인다. 실행에 성공한 기쁨은 잠깐이고, 그 다음부터는 답변을 기다리는 시간이 더 크게 다가온다. 돌아간다와 쓸 만하다 사이의 거리는 역시 멀다.
그래서 지금은 DeepSeek를 이 환경에서 본격적으로 쓰기보다는, 앞으로 나올 Qwen4가 더 기대된다. 어떤 사양과 속도로 나올지는 나와봐야 알겠지만, 내게 필요한 것은 거대한 모델을 간신히 띄웠다는 인증보다는 적당한 하드웨어에서 매일 부담 없이 쓸 수 있는 모델이니까. 그때도 또 깃헙 새로고침을 하고 있겠지…
참고: Strata GitHub · 0.2.4 릴리스 및 DeepSeek 수동 설치 안내. 작성 시점에는 같은 릴리스 페이지에 터미널 0.2.4.2의 설치·실행 관련 수정도 추가돼 있다. 위 결과는 내가 실행해 첨부한 화면 기준이며, 이후 버전에서 같은 성능이나 설치 문제가 그대로 재현된다는 뜻은 아니다.