AI가 똑똑해지면서 이제는 물어보는 말에 대답도 잘하고 시키는 일도 척척 해내는 이 때, 사람들은 ‘연초에는 매월 20달러만 줘도 토큰 걱정 없이 살았는데, 이제는 200달러 요금제도 리셋 되기만 기다리게 되는’ (티보 형님 만세…) 상황을 마주하게 되면서, ‘아, 내가 전기요금만 내면 내 PC에서 AI를 돌리면서 프라이버시도 지키고 매월 추가로 나가는 돈도 없다더라’는 도시전설급의 그 이야기 – Open Weight 으로 관심을 갖게 되는 사람들이 점점 늘어나고 있다. 물론, 그게 나다.
그런데, 사실 Open이라는 단어에 숨어 있는 여러가지 의미 중에는 ‘공짜, 무료, 자유’ 등등의 좋은 의미도 있겠지만, ‘니가 직접 알아서, 생각보다 낮은 퀄리티 (좋은건 돈받고 팔아야지…), 쉽지 않은 셋팅’ 등등이 잘 안보이는 곳에 있다가 결정적인 순간에 발목을 턱 하고 잡는 경우가 많다. 물론, AI도 예외가 아니다.
사실 가장 큰 진입 장벽은 하드웨어다. 맥미니가 유행했던 건 정말 저전력으로 최소 수준의 서버 흉내를 내어줄 수 있기 때문이었던거지, LLM을 상시로 돌리기 위한 것은 아니었다. 맥 스튜디오나 DGX Spark, Strix Halo같은 전문가급의 하드웨어가 있다면 좀 상황이 낫겠지만 이미 메모리 가격 덕분에 가격은 천정부지로 솟구쳐 올라서 월급쟁이의 취미 영역을 크게 벗어나 버린지 오래다.
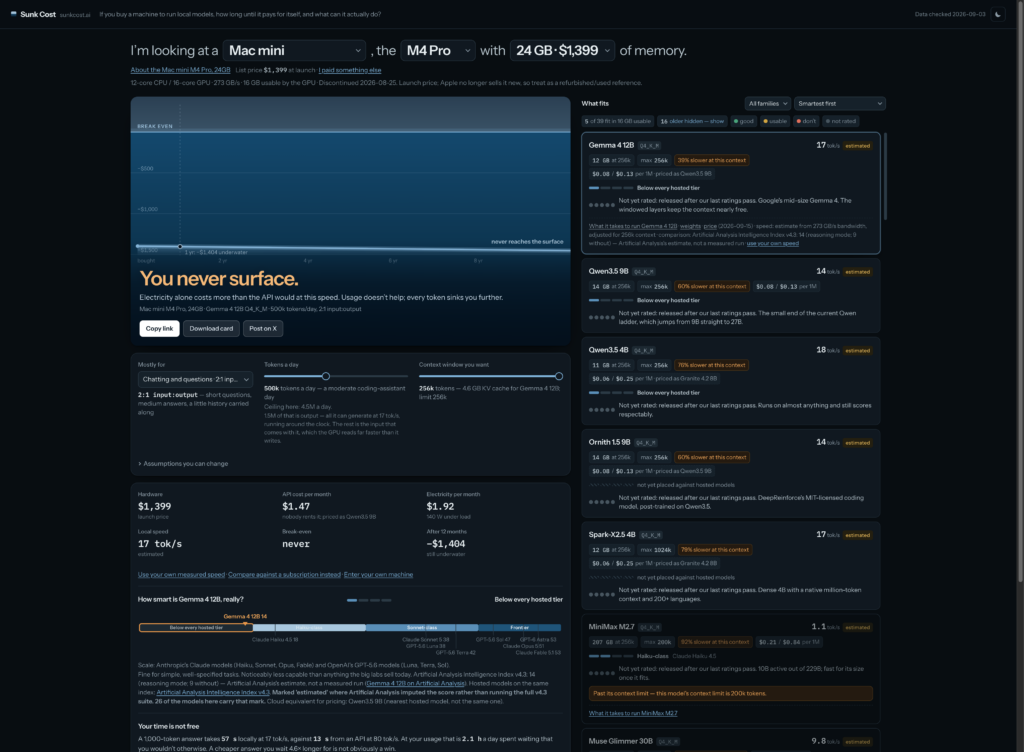
LLM을 굳이 로컬에서 돌리시겠다는 분들을 도시락 싸들고 말리기 위해 어느 선구자께서 만드신 웹사이트. sunkcost.ai M4 Pro 24GB의 고성능을 자랑하는 내 맥미니는 BEP 달성이 불가하다는 결론을 냉정하게 내주셨다.
더군다나 모델 성능 역시, 중국 형님들이 내주시는 공개 모델들이 이제 OpenAI나 Anthropic의 SOTA 모델들을 따라 잡아주는 성능을 내면서 황송하게도 open weight 까지 내어주시면서 몸둘바를 몰라 했지만… 그게 성능이 뛰어난 만큼이나 어마어마한 용량을 자랑하게 되다보니 이걸 통으로 메모리에 올려서 돌려야 하는 AI 모델 특성 상 어지간한 하드웨어로는 한 번 돌려보는 것도 어려울 정도.
미국 SOTA 모델들과 대놓고 경쟁하는 업체들 – DeepSeek 이나 GLM, Kimi 등등 은 성능은 정말 뛰어나지만 공개는 그냥 해줬다 수준인 경우가 많고 (수백기가 짜리 웨이트를 턱 하니 던져만 주시면… 일부 갑부들께서는 DGX Spark 두 대, 세 대 묶어서 돌리시던데… ), Qwen이나 Gemma 같이 양자화 모델도 착실히 내어 주시는 고마운 곳도 있지만 양자화 하면서 생기는 손실, 아니 그 보다 더 큰 ‘파라미터 수’라는 체급의 차이로 생기는 모델의 성능 이슈가 같이 따라오다 보니 막상 본격적으로 쓰기는 좀 애매한 경우들이 많이 생긴다.
물론, 필요한 상황에 맞춰 하네스 빡세게 구성하면 아쉬운대로 활용이 안되는건 아닌데다 그마저도 무료로 풀어주는 걸 감사해야 하는게 마땅하지만… 사람 마음이 어찌 그런가.
그나마 26년 9월 현재 Qwen3.8-27B 모델이 Q4 양자화 하면 32GB 이하 VRAM 갖고 있는 개인 PC 사양에서 돌아가는 가장 훌륭한 선택지로 모이는 분위기. 벤치마크가 아닌 실 사용 시 대략 클로드 소넷 급의 성능을 보여준다고 하더라. ‘하더라’인 이유는… 내 컴퓨터 환경에서는 돌려 볼 수가 없는 사양이기 때문에… (맥미니 살 때 좀 기다려서라도 메모리 넉넉하게 샀어야 하는데… ㅠㅠ)
오픈 웨이트 전체를 놓고 봤을 때도, Qwen의 다음 버전 미리보기(?) 모델인 Qwen3.8-Flash-Next가 127GB 메모리로 돌리는게 가능해서 그나마 128GB 메모리 갖춘 DGX Spark 등에 올려 놓는게 가능해서 여러 사람들이 써보고 환호하는 상황. 역시나 좋은 평가 받고 있는 Deepseek 4.1이나 GLM-5.3 flash 같은건 128GB를 훌쩍 넘기는 사양이라 그냥 open router 같은데서 싸게 쓰는게 최고로 보고 있다. 그러다보니 Qwen3.8-Flash-Next가지고 다이어트 빡세게 시켜서 좀 더 적은 메모리로 돌려보겠다고 다양한 시도들이 일어나고 있는 듯 하다. 뭐 Q1, Q2 로 내려가면 현실세계의 하드웨어로도 돌릴수 있다고는 하는데 초당 4토큰 만들어 내는 속도로 말 그대로 ‘되긴 한다’ 라서 의미는 없는 듯.
쓸만한 모델을 적당한 하드웨어에서 돌린다는 허상, 그런데 그것이 실제로 일어났습니다?
그런데, 얼마 전 12GB VRAM이 있는 Nvidia 그래픽카드를 사용하는 윈도우/리눅스 PC에 RAM이 64GB 이상 있다면 Qwen3.8-27B가 아닌 Flash-Next를 초당 40~50토큰의 속도로 뽑아준다는 내용의 글이 X와 스레드에 떠돌게 됩니다.
MoE 구조를 해체 분해해서 필요한 것만 양자화 하는 걸로는 모자란지, VRAM, RAM, SSD를 살뜰히 쪼개서 비싼 VRAM에는 정말 필요한 부분과 Cache만 올려놓고 나머지는 RAM과 SSD에 나눠놓고 필요할때마다 불러 쓰는 구조인가 봅니다. 말은 되는 듯 하지만 실제로 구현해 냈다는게 더 놀랍습니다. 뭐 더 잘 아시는 분들의 말로는 정말 Qwen 구조에만 맞게 최적화를 극한까지 해놨다는거 같은데… 여기서부터는 미지의 영역이라…
모델을 3단 분리해서 각각에 맞는 저장장소에 올려놓고 씁니다. 출처 : Niko1221 Github
그래서, 10년 전 확보해둔 메모리 덕분에 램은 64GB (하지만 DDR4…), 그래픽카드는 게임 한 번 4k로 돌려보겠다고 사둔 4080 SUPER (16GB GDDR5) 가 꽂혀있는 PC에 바로 설치해봤습니다.
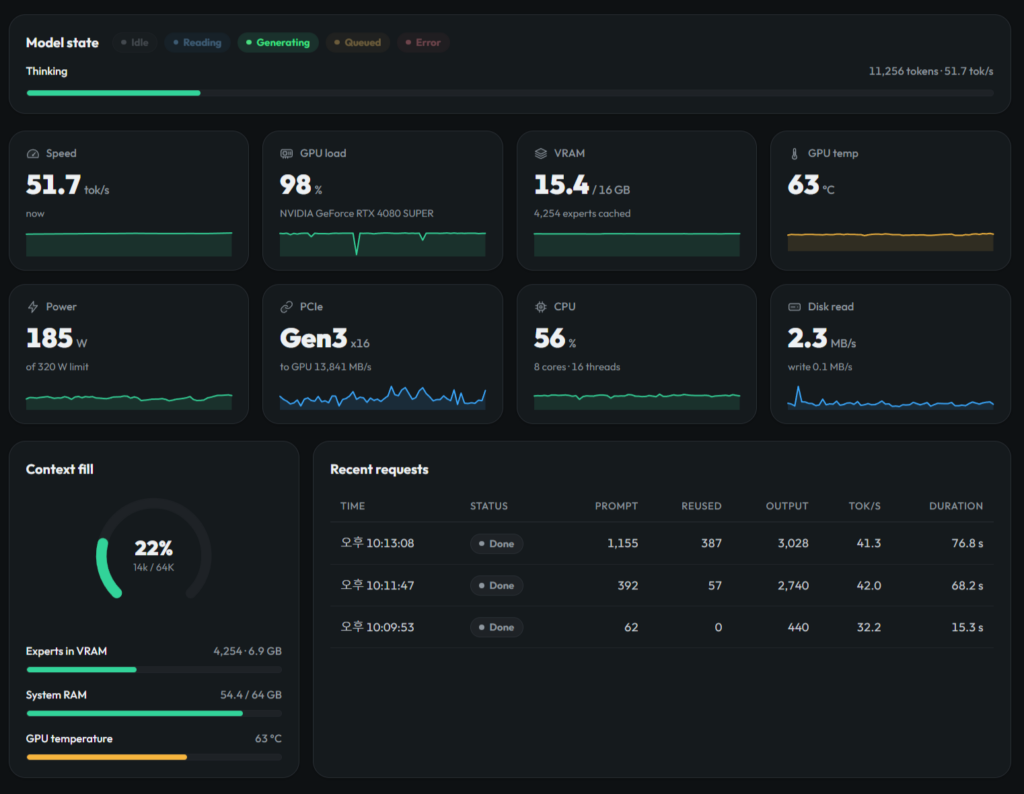
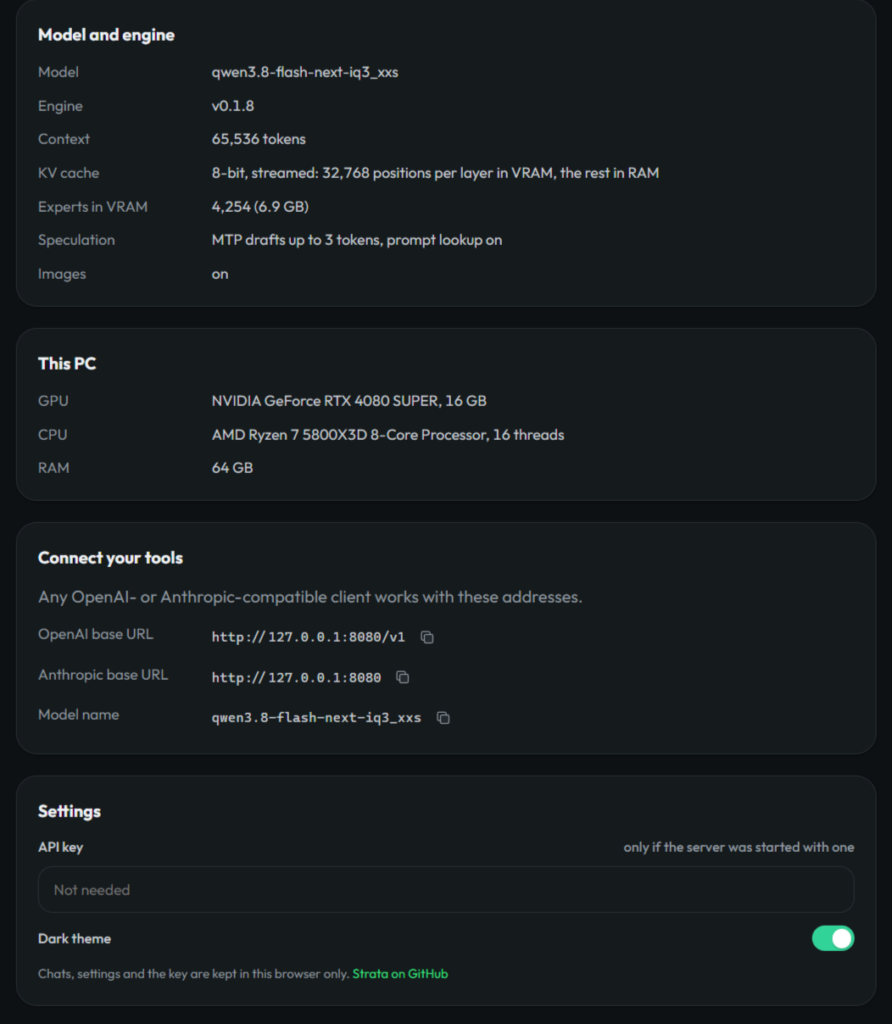
설치는 정말 간단합니다. 정말 저 개발자는 천재임이 분명합니다. github에서 파일을 zip으로 내려받고, 압축 풀어서 그 안에 있는 ‘Start-here.bat’를 실행하면 알아서 다 해줍니다. 모델도 내려 받고 설치가 다 끝나면 친숙한 웹 화면을 띄워줍니다. 보면 현재 시스템 상황도 보여주고, 설치된 PC 사양도 보여줍니다.
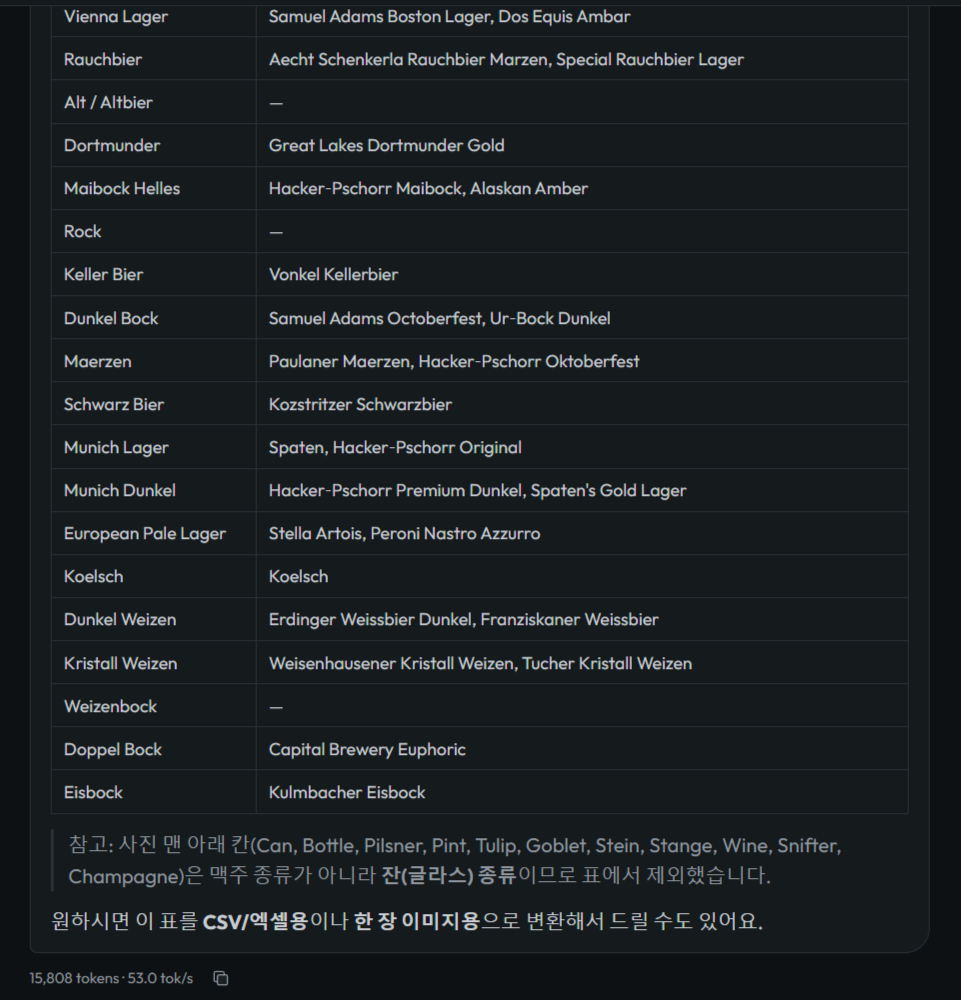
재밌는 이야기 해달라고 하니 바로 던져줍니다. 간단한 게임 (숫자야구게임…)도 뚝딱 만들어 냅니다. 다른 것 보다 속도가 예술입니다. 프롬프트 바로 읽고 Thinking에 토큰들 던지기 시작하더니 답도 후루룩 냅니다. 내용은 기대한 수준이긴 합니다. 뭐 이정도는 20B 이하 모델들도 잘 하니까, 좀 어려운게 뭐가 있을까 해서 0.9GB나 더 써서 내려받은 이미지 모델 활용해 볼 겸 사람이 봐도 복잡한 그림을 던져주고 그 안에 내용을 좀 구분해서 정리해 달라고 보냈습니다.
그랬더니,
짜잔. 3~4분 생각하고 (Reasoning을 High로 놓았더니…) 표로 주욱 뿌려줍니다. 속도는 53tps 가 나왔네요.
근데 표가 좀 몇 개 빠진 듯 해서 잡도리를 해봅니다.
그랬더니 무한루프에 빠지는 로컬모델에서 자주보던 모습을 다시 마주하게 되네요.
그럼에도 불구하고 뭔가 가능성이 보였다는 점, 아직 시작인 프로젝트라는 점이 기대를 갖게 합니다. 당분간 깃헙 새로고침 하면서 업데이트 내용 살펴봐야 할 듯 하네요. 혹시 애매한 사양으로 LLM 찍먹도 못하고 계셨던 저같은 분들 계시면 한 번 시도해 보실만 할 것 같습니다.
또 AMD가 한 세대를 넘겼다. 아니, 넘겼다고 하기엔 좀 애매한데… 암튼 작년 로컬 LLM 동네를 들썩이게 했던 Strix Halo(Ryzen AI Max 300 시리즈) 후속으로 5월에 Gorgon Halo(Ryzen AI Max PRO 400 시리즈)라는게 발표됐고, 이번 IFA 2026을 기점으로 실제 제품들이 슬슬 얼굴을 내밀기 시작했다. 맥미니에 로컬 LLM 올려놓고 깨작거리다 보면 “메모리만 좀 더 있었으면…”하는 순간이 꼭 오는데, 그 가려운 데를 긁어주겠다고 나온 물건이라 그냥 지나칠 수가 없었다. (네, 그 병이 또 도졌다.)
그래서 정리해봤다. 두 칩이 실제로 뭐가 다른지, 각각 어디까지 큰 모델을 올릴 수 있고 그때 토큰이 얼마나 나오는지, 그리고 지금 “진짜로” 출시 확정된 제품은 뭐가 있는지.
한 줄 요약부터
Gorgon Halo는 Strix Halo에 메모리만 192GB로 늘려준 리프레시다. 아키텍처(Zen 5 + RDNA 3.5 + XDNA 2)는 그대로고, 속도도 거의 그대로. 대신 “더 큰 모델을” 혹은 “같은 모델을 덜 깎아서” 올릴 수 있게 됐다. 이게 전부다. 진짜로.
1. 스펙 비교: 뭐가 달라졌나
양쪽 플래그십인 Ryzen AI Max+ 395랑 Ryzen AI Max+ PRO 495를 놓고 보면 이렇다.
항목
Strix Halo (Ryzen AI Max+ 395)
Gorgon Halo (Ryzen AI Max+ PRO 495)
CPU
Zen 5, 16코어 / 32스레드
Zen 5, 16코어 / 32스레드 (동일)
CPU 부스트 / 베이스
5.1 GHz / 3.0 GHz
5.2 GHz / 3.1 GHz (+100MHz)
GPU
Radeon 8060S, RDNA 3.5, 40CU, 2.9GHz
Radeon 8065S, RDNA 3.5, 40CU, 3.0GHz
NPU (XDNA 2)
50 TOPS
55 TOPS
총 AI 연산
126 TOPS
131 TOPS
최대 통합 메모리
128GB LPDDR5X-8000
192GB LPDDR5X-8533
최대 VRAM 할당
96GB
160GB
메모리 대역폭
256 GB/s
273 GB/s (+6.6%)
캐시
80MB
80MB (동일)
cTDP
45-120W
45-120W (동일)
보다시피 CPU/GPU 클럭 각각 100MHz씩 올라간게 전부고, 공정도 코어 수도 CU 수도 캐시도 TDP도 다 그대로다. 유출된 PassMark 기준으로 멀티 10%, 싱글 5% 정도 오른 모양인데, 이건 전압-주파수 커브 살짝 손본 정도로 보인다. 해외 리뷰어 중엔 대놓고 “이름만 바꾼 리배지”라고 하는 사람도 있더라. 뭐… 틀린 말은 아니다.
진짜 바뀐 건 메모리 컨트롤러다. SoC 다이의 메모리 컨트롤러를 손봐서 192GB LPDDR5X-8533까지 붙일 수 있게 됐고, 그중 160GB를 GPU 쪽으로 몰아줄 수 있다. AMD 공식 멘트로는 “4bit 양자화 기준 300B 이상 파라미터를 로컬에서 돌리는 최초의 x86 클라이언트 프로세서”란다. 마케팅 멘트치고는 꽤 구체적이라 오히려 신뢰가 간다.
근데 아쉬운 점도 분명하다. 메모리 버스가 여전히 256비트라 대역폭은 256GB/s에서 273GB/s로 6.6%밖에 안 늘었다. 딱 DGX Spark 수준. 메모리는 커졌는데 대역폭이 그대로라는 건, 큰 모델을 올릴 수는 있어도 토큰 뽑는 속도는 안 빨라진다는 얘기다. 이게 왜 중요한지는 바로 다음에.
참고로 라인업은 PRO 495(16코어/40CU), PRO 490(12코어/32CU), PRO 485(8코어/32CU) 세 종류인데, 하위 모델도 전부 192GB 지원이다. 비(非)PRO 버전은 늘 그렇듯 “coming soon”.
2. 토큰 속도는 “모델 크기”가 정하는게 아니다
이 동네 칩들의 LLM 성능을 이해하려면 딱 하나만 기억하면 된다. Halo 계열은 메모리 대역폭 병목이다. iGPU가 아무리 좋아도, NPU가 55 TOPS건 뭐건, 토큰 생성 속도는 결국 “토큰 하나 만들 때 메모리에서 읽어야 하는 양”을 대역폭으로 나눈 값으로 수렴한다.
그래서 총 파라미터 수보다 활성 파라미터 x 양자화 비트가 훨씬 중요하다. 235B짜리 MoE라도 토큰당 활성이 22B면 22B만큼만 읽으면 되고, 70B dense는 매 토큰마다 70B를 통째로 읽어야 한다. 그래서 Halo 계열에서는 MoE가 비슷한 크기 dense보다 3배에서 14배까지 빠르다.
감을 잡기 위한 기준 하나. 50 tok/s면 거의 즉답 느낌이고, 15-20 tok/s면 채팅용으로 무난하고, 5 tok/s 아래는 reasoning 모델에서는 생각하는거 기다리다 딴짓하게 되는 수준이다.
3. Strix Halo (128GB): 실측 데이터
Strix Halo는 이미 1년 넘게 전세계 홈랩러들이 굴려온 플랫폼이라 실측치가 넘쳐난다. 실제로 쓸 수 있는 VRAM은 OS 예약분 빼고 96-120GB 정도. 이 안에 70B Q4 dense 전부랑 120B급 MoE 대부분이 들어간다. 아래는 llama.cpp 기준 커뮤니티 실측치들을 모아본 것.
모델
구조
양자화 / 용량
생성 속도 (실측)
gpt-oss-120b
MoE (5B 활성)
MXFP4, 59GB
45-55 tok/s
Qwen3.5 122B-A10B
MoE (10B 활성)
MXFP4, 70GB
약 19 tok/s
Llama 4 Scout 109B
MoE (17B 활성)
Q4, 61GB
약 19 tok/s
Nemotron 3 Super 120B-A12B
MoE (12B 활성)
IQ4, 약 60GB
약 18 tok/s
Qwen3-235B-A22B
MoE (22B 활성)
Q3_K_M, 105GB
약 8 tok/s
Llama 3.3 70B
Dense
Q4, 42GB
약 5 tok/s
Llama 3.3 70B
Dense
Q6, 54GB
약 4 tok/s
Strix Halo의 상한선은 단일 기기에서 235B MoE를 Q3로 겨우 밀어넣는 정도다(105GB, 8 tok/s). MiniMax M2 230B급이나 284B급 GGUF를 올린 사례도 있긴 한데… “올라간다”랑 “쓸만하다”는 엄연히 다른 얘기다. 실용적인 sweet spot은 120B급 MoE(약 50 tok/s)고, 70B dense는 5 tok/s로 좀 답답하다.
4. Gorgon Halo (192GB): 추정치
Gorgon Halo는 아직 시장에 풀린 물건이 없어서 독립적인 실측치가 없다. 다만 대역폭이 6.6% 늘었으니 같은 모델이면 Strix Halo보다 5-7% 빠른 정도로 보면 될 것 같다. 아래 표는 Strix Halo 실측치를 대역폭 비율로 환산해서 뽑아본 추정치라 그 정도 감안하고 봐주시길.
모델
구조
양자화 / 용량
예상 속도 (추정)
Qwen3-235B-A22B
MoE (22B 활성)
Q4_K_M, 약 135GB
8-10 tok/s (Q3 대신 Q4로 품질 확보)
Qwen3.5-397B-A17B
MoE (17B 활성)
Q2-Q3, 140-160GB
12-18 tok/s
GLM-4.5 355B-A32B
MoE (32B 활성)
Q3, 약 150GB
5-7 tok/s
DeepSeek V3/R1 671B
MoE (37B 활성)
1.5-2bit, 약 160GB
3-5 tok/s (품질 손실 큼, 비추천)
120B급 MoE
MoE
Q8 (고품질), 약 120GB
25-30 tok/s
70B dense
Dense
Q8, 75GB
약 3 tok/s
참고할 만한 공식 수치가 하나 있는데, Minisforum이 MS-S1 MAX-P495 2대를 클러스터로 묶어서 Qwen3.5-397B를 16 tok/s로 돌렸다고 한다. 한 대라면 이보다 양자화를 더 깎아서 10-15 tok/s 정도가 현실적인 추정.
그러니까 Gorgon Halo의 가치는 “더 빠르게”가 아니라 “더 크게, 혹은 더 정확하게”다. 235B MoE를 Q3 대신 Q4로 올리거나, 400B급 MoE를 저비트로 억지로라도 올리거나, 120B급 MoE를 Q8로 여유 있게 돌리거나. 이게 192GB가 열어주는 선택지다. 반대로 지금 128GB로 충분히 만족하고 있다면 갈아탈 이유는… 솔직히 거의 없다.
신제품이 발표된 이 시점에 뭘 골라야 하는가에 대해서는 사실 나도 고민이라… Mac Studio 128GB이 눈 앞에 아른거리지만… 그렇지만…
5. 그래서 지금 살 수 있는 건?
9월 초 IFA 2026을 기점으로 제품 발표가 줄줄이 이어지는 중이다. 출시 시점을 확실히 밝힌 것과 아직 티저 단계인 것을 나눠보면 이렇다.
출시 시점을 공식으로 밝힌 제품
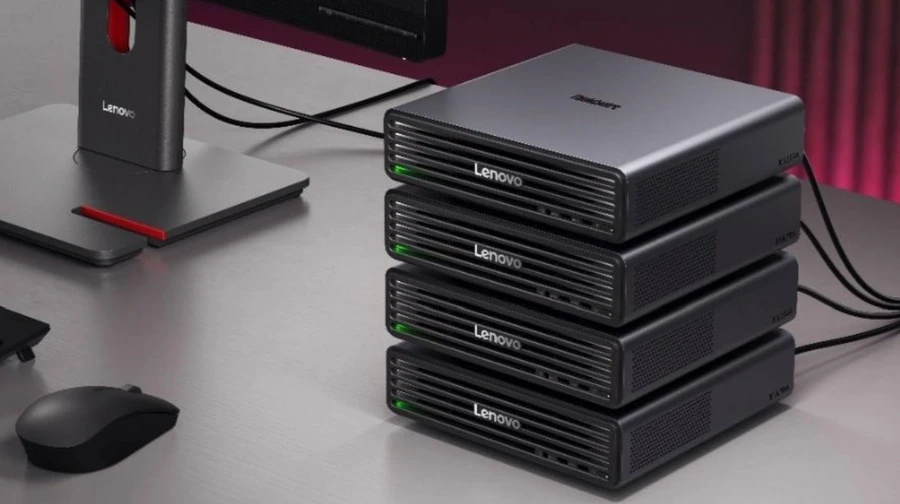
Lenovo ThinkCentre X Ultra (1.6L, 최대 128GB): 가장 구체적이다. 2026년 11월 출시, 미국 시작가 $3,699. Windows 11이나 Linux 중 고를 수 있고, 10GbE에 Thunderbolt 4 두 개. 레노보는 이걸 4대 쌓아서 클러스터로 쓰라고 대놓고 밀고 있다.
Lenovo ThinkCentre X Ultra. 1.6L 크기에 Ryzen AI Max+ PRO 495와 최대 128GB 메모리를 담았다. 나도 저렇게 4대 쌓아놓고 써봤으면 좋겠다… (출처: Lenovo)
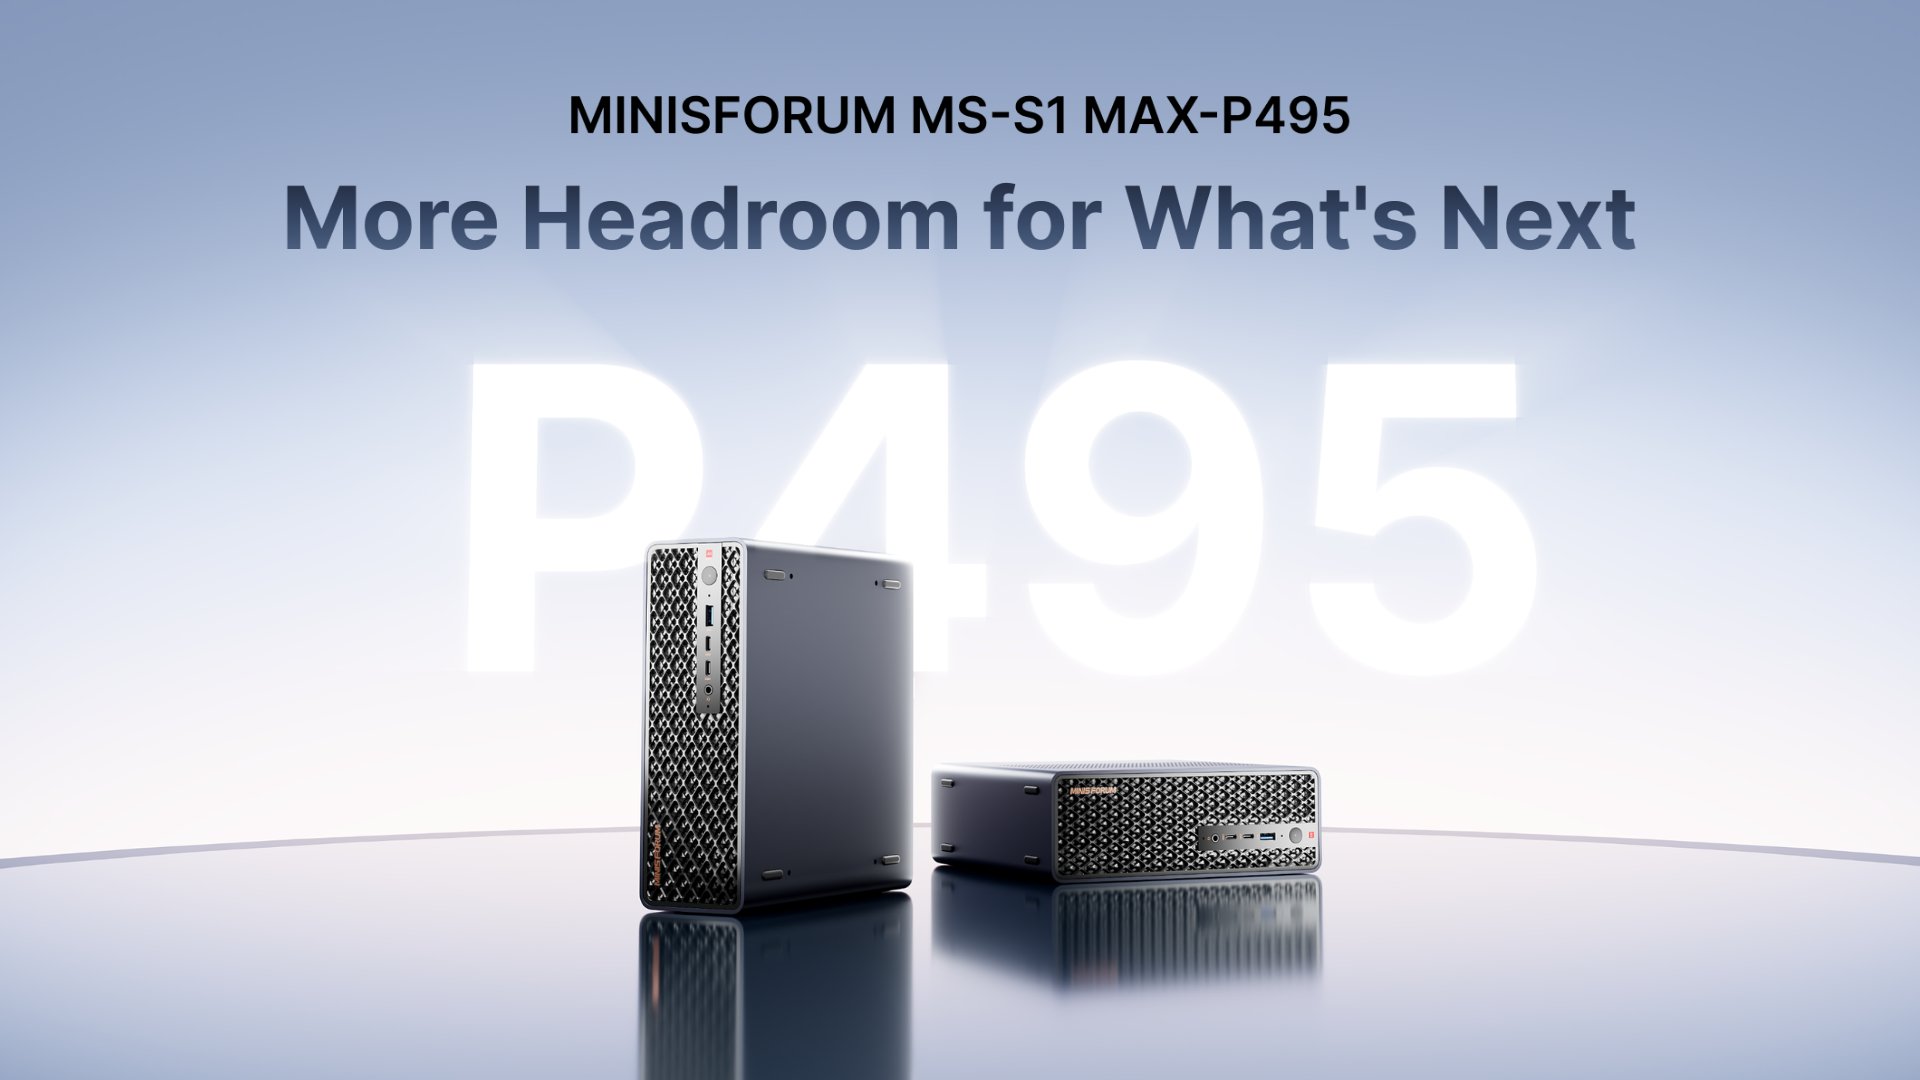
MINISFORUM MS-S1 MAX-P495 (192GB): IFA 2026에서 공식 발표, 9월 중 판매 시작 예정. 160GB VRAM 할당에 2U 랙 마운트 지원. 가격은 아직 안 나왔는데 EU 스토어에 “€7???” 라고 티저를 띄워놔서 대충 7,000-8,000달러대로 추정된다. 같은 칩 박은 5베이 NAS인 N5 MAX-P495도 같이 나왔다.
MINISFORUM MS-S1 MAX-P495. 192GB 통합 메모리, 160GB VRAM 할당, 2U 랙 마운트 지원. 여긴 변태 스펙의 NAS 출시를 즐기는 모양이다. 폼팩터는 MS-S1이 워낙 잘 뽑혀서 계속 가는 듯.(출처: MINISFORUM)
발표는 했는데 판매일은 아직인 제품
GMKtec EVO-X5 Pro: IFA 2026(9월 5일) 공개. 판매일이랑 가격은 미정. 192GB 최상위는 4,000달러대라는 얘기가 돌고 있다. USB4 4포트에 10GbE 포함 이더넷 2포트, USB4로 외장 GPU 연결 및 최대 4대 클러스터 구성이 가능하다. 부스에서 Qwen3.8-Flash-Next 라이브 데모를 공개했다(바로 아래).
Framework Desktop 192GB: 공식 페이지에 “coming soon” 탭만 덜렁.
ACEMAGIC F9A (192GB): 공개는 됐는데 출시일은 미확인.
AMD Ryzen AI Halo 개발 플랫폼 (Gorgon 버전): AMD가 “3분기 중” OEM 시스템이랑 같이 나온다고만 한 상태.
참고: EVO-X5 Pro 부스 데모에서 첫 공개 수치가 나왔다
위 목록에서 ‘실제로 돌아가는 모습’이 공개된 건 EVO-X5 Pro가 유일하다. IFA 2026 GMKtec 부스 라이브 데모에서 EVO-X5 Pro가 Qwen3.8-Flash-Next를 구동했는데, Notebookcheck 현장 기사에 따르면 토큰 생성 속도가 초당 두 자릿수로 안정적으로 나와 거의 실시간 대화가 가능한 수준이었다고 한다.
데모 화면을 찍은 사진을 뜯어보면 수치가 더 구체적으로 나온다. LM Studio 로컬 서버(127.0.0.1:8080)에 Qwen3.8-Flash-Next-UD-Q4_K_XL(Unsloth Dynamic 4비트 양자화)이 올라가 있었고, 마지막 응답 기준 3.7초에 67토큰, 즉 17.9 tok/s였다. 이 글에서 기준으로 삼은 속도 구간으로 치면 “채팅용으로 무난한” 15-20 tok/s 구간이다.
물론 공식 벤치마크가 아니라 부스 데모 화면 사진에서 읽어낸 수치라 컨텍스트 길이나 프롬프트 처리 속도 같은 조건은 알 수 없다. 그래도 192GB에 4비트 모델이 통째로 올라가서 두 자릿수 토큰이 나오는 걸 눈으로 본 첫 사례라는 점에서, 4번 섹션의 추정표가 크게 틀리지 않았다는 방증 정도로 기록해둔다. 출처는 Notebookcheck의 IFA 2026 현장 기사.
6. 그럼 DGX Spark는?
이 가격대에서 Halo 계열의 직접적인 맞수는 아무래도 NVIDIA DGX Spark다. GB10 Grace Blackwell에 128GB LPDDR5X를 얹은 박스인데, 대역폭이 273GB/s라 Gorgon Halo랑 똑같고 Strix Halo보단 7% 정도 높다. 그래서 토큰 생성 속도는 셋 다 거기서 거기다. gpt-oss-120b 기준으로 DGX Spark 52-56 tok/s, Strix Halo 45-55 tok/s니까 오차 범위 안. 차이가 벌어지는 건 프롬프트 처리(prefill) 쪽인데, 이건 대역폭이 아니라 연산 성능 싸움이라 Blackwell 텐서코어 + CUDA 조합이 훨씬 세다. 2-5배 정도. 긴 문서 던져넣거나 컨텍스트 빵빵한 에이전트 돌릴 때 첫 토큰 나올 때까지의 기다림이 체감상 꽤 다르다. 이미지 생성 같은 순수 연산 작업도 2.5배 정도 DGX Spark가 앞선다.
항목
NVIDIA DGX Spark
Strix Halo (128GB)
Gorgon Halo (192GB)
통합 메모리
128GB
128GB
192GB
대역폭
273 GB/s
256 GB/s
273 GB/s
AI 연산 (공식)
~1 PFLOP FP4
126 TOPS
131 TOPS
OS
Linux 전용 (DGX OS)
Windows / Linux
Windows / Linux
소프트웨어 스택
CUDA, TensorRT-LLM, vLLM
ROCm / Vulkan, llama.cpp
ROCm / Vulkan, llama.cpp
토큰 생성 (120B MoE)
52-56 tok/s
45-55 tok/s
50-60 tok/s (추정)
프롬프트 처리
매우 빠름 (기준)
2-5배 느림
2-5배 느림 (추정)
가격
$3,999-4,699
$2,000-4,000
$3,699 (128GB) / 7,000달러대 (192GB)
그러면 Gorgon Halo 192GB가 DGX Spark 대비 갖는 의미는 명확하다. DGX Spark는 한 대로는 200B 언저리가 한계고 그 이상은 두 대를 ConnectX-7로 묶어야 하는데, Gorgon Halo는 한 대로 300B급 4bit를 올린다. 반대로 CUDA 생태계, 파인튜닝, 빠른 프롬프트 처리가 필요하면 여전히 DGX Spark가 편하다. 정리하면 “제일 큰 모델 한 대에 올려놓고 채팅/추론 위주로 쓰겠다”면 Gorgon Halo, “CUDA로 개발하고 긴 컨텍스트 자주 넣겠다”면 DGX Spark. 다만 192GB Gorgon Halo가 7,000달러대로 예상되는 만큼 DGX Spark 두 대(256GB) 값이랑 겹치는 구간이라… 가성비 판단은 실제 출시가 나온 뒤에 다시 해봐야 할 것 같다.
Gorgon Halo(192GB)는 235B MoE를 Q4로 8-10 tok/s, 400B급 MoE를 저비트로 10-15 tok/s 정도로 추정. 속도가 아니라 용량이랑 양자화 품질에서 이득.
어느 쪽이든 MoE 위주로 골라야 한다. 대형 dense는 둘 다 실용성 없음.
DGX Spark랑 비교하면 토큰 생성은 거의 같고, 프롬프트 처리랑 CUDA 생태계는 DGX Spark가, 한 대에 올릴 수 있는 최대 모델 크기는 Gorgon Halo가 앞선다.
지금 날짜랑 가격까지 다 나온 건 Lenovo ThinkCentre X Ultra(11월, $3,699)가 유일하고, Minisforum MS-S1 MAX-P495는 9월 내 판매 예정.
Gorgon Halo 쪽 속도 수치는 제품이 아직 안 나와서 실측이 없고, Strix Halo 실측치에 대역폭 비율 곱해서 뽑은 추정치라는 점은 다시 한 번. 실제 리뷰들이 하나 둘 나오는 시점에 다시 한 번 업데이트 해보겠다… 뭐… 내가 직접 하면 더 좋을지도 모르겠지만…